
编程开发
切片copy
当我们需要在Go语言中复制一个切片时,我们可以使用内置的copy函数。copy函数可以将一个切片的元素复制到另一个切片中。下面是一个示例: 在上面的示例中,我们首先创建了一个源切片
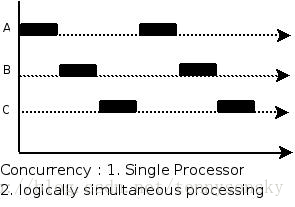
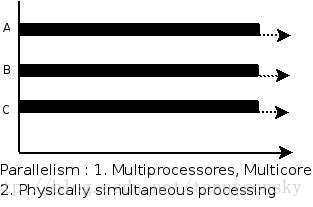 并发(concurrency):指在同一时刻只能有一条指令执行,但多个进程指令被快速的轮换执行,使得在宏观上具有多个进程同时执行的效果,但在微观上并不是同时执行的,只是把时间分成若干段,使多个进程快速交替的执行。
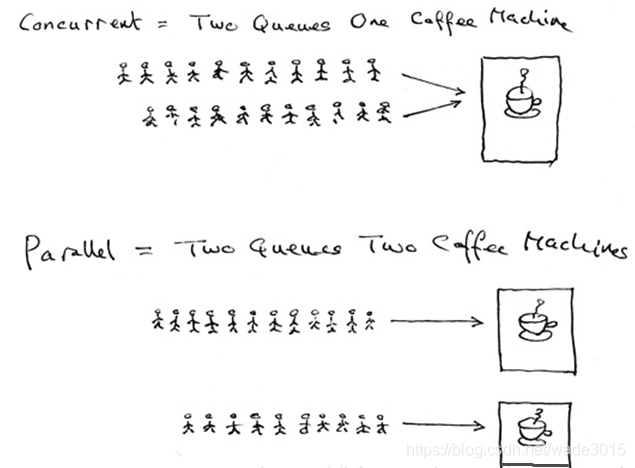
 并行是两个队列同时使用两台咖啡机,并发是两个队列交替使用一台咖啡机
package main

import (
    "fmt"
    "time"
)

func newTask() {
    i := 0
    for {
        i++
        fmt.Printf("new goroutine: i = %d\n", i)
        time.Sleep(1 * time.Second) //延时1s
    }
}

func main() {
    go newTask()   //创建一个 goroutine,启动另外一个任务
    i := 0
    for {          //main goroutine 循环打印
        i++
        fmt.Printf("main goroutine: i = %d\n", i)
        time.Sleep(1 * time.Second) //延时1s
    }
}
程序运行结果:
main goroutine: i = 1
new goroutine: i = 1
main goroutine: i = 2
new goroutine: i = 2
main goroutine: i = 3
new goroutine: i = 3
……
以下的程序,我们串行地去执行两次
loop函数:
func loop() {
    for i := 0; i < 10; i++ {
        fmt.Printf("%d ", i)
    }
}

func main() {
    loop()
    loop()
}
毫无疑问,输出会是这样的:
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9下面我们把一个loop放在一个goroutine里跑,我们可以使用关键字
go来定义并启动一个goroutine:
func main() {
    go loop() // 启动一个goroutine
    loop()
}
输出结果:
0 1 2 3 4 5 6 7 8 9可是为什么只输出了一趟呢?明明我们主线跑了一趟,也开了一个goroutine来跑一趟啊。 原来,在goroutine还没来得及跑loop的时候,主函数已经退出了。 main函数退出地太快了,我们要想办法阻止它过早地退出,一个办法是让main等待一下:
func main() {
    go loop()
    loop()
    time.Sleep(time.Second) // 停顿一秒
}
这次确实输出了两趟,目的达到了。可是采用等待的办法并不好,如果goroutine在结束的时候,告诉下主线说“Hey, 我要跑完了!”就好了,这就是接下来要讲到的信道。
var ch chan int      // 声明一个传递int类型的channel
ch := make(chan int) // 使用内置函数make()定义一个channel

//=========
ch <- value          // 将一个数据value写入至channel,这会导致阻塞,直到有其他goroutine从这个channel中读取数据
value := <-ch        // 从channel中读取数据,如果channel之前没有写入数据,也会导致阻塞,直到channel中被写入数据为止

//=========
close(ch)            // 关闭channel
使用
make来建立一个信道:
var channel chan int = make(chan int) // 或channel := make(chan int)那如何向信道存消息和取消息呢? 一个例子:
func main() {
    var messages chan string = make(chan string)
    go func(message string) {
        messages <- message // 存消息
    }("Ping!")
    fmt.Println(<-messages) // 取消息
}
默认的,信道的存消息和取消息都是阻塞的 (叫做无缓冲的信道,不过缓冲这个概念稍后了解,先说阻塞的问题)。
也就是说, 无缓冲的信道在取消息和存消息的时候都会挂起当前的goroutine,除非另一端已经准备好。
比如以下的main函数和foo函数:
var ch chan int = make(chan int)

func foo() {
    ch <- 0  // 向ch中加数据,如果没有其他goroutine来取走这个数据,那么挂起foo, 直到main函数把0这个数据拿走
}

func main() {
    go foo()
    <- ch // 从ch取数据,如果ch中还没放数据,那就挂起main线,直到foo函数中放数据为止
}
那既然信道可以阻塞当前的goroutine, 那么回到上一部分「goroutine」所遇到的问题「如何让goroutine告诉主线我执行完毕了」 的问题来, 使用一个信道来告诉主线即可:
var complete chan int = make(chan int)

func loop() {
    for i := 0; i < 10; i++ {
        fmt.Printf("%d ", i)
    }
    complete <- 0 // 执行完毕了,发个消息
}

func main() {
    go loop()
    <- complete // 直到线程跑完, 取到消息. main在此阻塞住
}
如果不用信道来阻塞主线的话,主线就会过早跑完,loop线都没有机会执行、、、
其实,无缓冲的信道永远不会存储数据,只负责数据的流通,为什么这么讲呢?
func main() {
    ch := make(chan int)
    <- ch // 阻塞main goroutine, 信道c被锁
}
执行这个程序你会看到Go报这样的错误:
fatal error: all goroutines are asleep - deadlock!何谓死锁? 操作系统有讲过的,所有的线程或进程都在等待资源的释放。如上的程序中, 只有一个goroutine, 所以当你向里面加数据或者存数据的话,都会锁死信道, 并且阻塞当前 goroutine, 也就是所有的goroutine(其实就main线一个)都在等待信道的开放(没人拿走数据信道是不会开放的),也就是死锁咯。 我发现死锁是一个很有意思的话题,这里有几个死锁的例子: 1、只在单一的goroutine里操作无缓冲信道,一定死锁。比如你只在main函数里操作信道:
func main() {
    ch := make(chan int)
    ch <- 1 // 1流入信道,堵塞当前线, 没人取走数据信道不会打开
    fmt.Println("This line code wont run") //在此行执行之前Go就会报死锁
}
2、如下也是一个死锁的例子:
var ch1 chan int = make(chan int)
var ch2 chan int = make(chan int)

func say(s string) {
    fmt.Println(s)
    ch1 <- <- ch2 // ch1 等待 ch2流出的数据
}

func main() {
    go say("hello")
    <- ch1  // 堵塞主线
}
其中主线等ch1中的数据流出,ch1等ch2的数据流出,但是ch2等待数据流入,两个goroutine都在等,也就是死锁。
3、其实,总结来看,为什么会死锁?非缓冲信道上如果发生了流入无流出,或者流出无流入,也就导致了死锁。或者这样理解 Go启动的所有goroutine里的非缓冲信道一定要一个线里存数据,一个线里取数据,要成对才行 。所以下面的示例一定死锁:
c, quit := make(chan int), make(chan int)

go func() {
   c <- 1  // c通道的数据没有被其他goroutine读取走,堵塞当前goroutine
   quit <- 0 // quit始终没有办法写入数据
}()

<- quit // quit 等待数据的写
仔细分析的话,是由于:主线等待quit信道的数据流出,quit等待数据写入,而func被c通道堵塞,所有goroutine都在等,所以死锁。
简单来看的话,一共两个线,func线中流入c通道的数据并没有在main线中流出,肯定死锁。
但是,是否果真 所有不成对向信道存取数据的情况都是死锁?
如下是个反例:
func main() {
    c := make(chan int)

    go func() {
       c <- 1
    }()
}
程序正常退出了,很简单,并不是我们那个总结不起作用了,还是因为一个让人很囧的原因,main又没等待其它goroutine,自己先跑完了, 所以没有数据流入c信道,一共执行了一个goroutine, 并且没有发生阻塞,所以没有死锁错误。
那么死锁的解决办法呢?
最简单的,把没取走的数据取走,没放入的数据放入, 因为无缓冲信道不能承载数据,那么就赶紧拿走!
具体来讲,就死锁例子3中的情况,可以这么避免死锁:
c, quit := make(chan int), make(chan int)

go func() {
    c <- 1
    quit <- 0
}()

<- c // 取走c的数据!
<-quit
另一个解决办法是缓冲信道, 即设置c有一个数据的缓冲大小:
c := make(chan int, 1)这样的话,c可以缓存一个数据。也就是说,放入一个数据,c并不会挂起当前线, 再放一个才会挂起当前线直到第一个数据被其他goroutine取走, 也就是只阻塞在容量一定的时候,不达容量不阻塞。
var ch chan int = make(chan int)

func foo(id int) { //id: 这个routine的标号
    ch <- id
}

func main() {
    for i := 0; i < 5; i++ {     // 开启5个routine
        go foo(i)
    }
    for i := 0; i < 5; i++ {     // 取出信道中的数据
        fmt.Print(<- ch)
    }
}
我们开了5个goroutine,然后又依次取数据。其实整个的执行过程细分的话,5个线的数据 依次流过信道ch, main打印之, 而宏观上我们看到的即 无缓冲信道的数据是先到先出,但是 无缓冲信道并不存储数据,只负责数据的流通
var ch chan int = make(chan int, 2) // 写入2个元素都不会阻塞当前goroutine, 存储个数达到2的时候会阻塞如下的例子,缓冲信道ch可以无缓冲的流入3个元素:
func main() {
    ch := make(chan int, 3)
    ch <- 1
    ch <- 2
    ch <- 3
}
如果你再试图流入一个数据的话,信道ch会阻塞main线, 报死锁。
也就是说,缓冲信道会在满容量的时候加锁。
其实,缓冲信道是先进先出的,我们可以把缓冲信道看作为一个线程安全的队列:
func main() {
    ch := make(chan int, 3)
    ch <- 1
    ch <- 2
    ch <- 3

    fmt.Println(<-ch) // 1
    fmt.Println(<-ch) // 2
    fmt.Println(<-ch) // 3
}
range来读取信道:
func main() {
    ch := make(chan int, 3)
    ch <- 1
    ch <- 2
    ch <- 3

    for v := range ch {
        fmt.Println(v)
    }
}
如果你执行了上面的代码,会报死锁错误的,原因是range不等到信道关闭是不会结束读取的。也就是如果 缓冲信道干涸了,那么range就会阻塞当前goroutine, 所以死锁咯。
那么,我们试着避免这种情况,比较容易想到的是读到信道为空的时候就结束读取:
ch := make(chan int, 3)
ch <- 1
ch <- 2
ch <- 3
for v := range ch {
    fmt.Println(v)
    if len(ch) <= 0 { // 如果现有数据量为0,跳出循环
        break
    }
}
以上的方法是可以正常输出的,但是注意检查信道大小的方法不能在信道存取都在发生的时候用于取出所有数据,这个例子 是因为我们只在ch中存了数据,现在一个一个往外取,信道大小是递减的。
另一个方式是显式地关闭信道:
ch := make(chan int, 3)
ch <- 1
ch <- 2
ch <- 3

// 显式地关闭信道
close(ch)

for v := range ch {
    fmt.Println(v)
}
被关闭的信道会禁止数据流入, 是只读的。我们仍然可以从关闭的信道中取出数据,但是不能再写入数据了。
下面看一个生产者和消费者的例子:
func produce(p chan<- int) {
    for i := 0; i < 10; i++ {
        p <- i
        fmt.Println("send:", i)
    }
}
func consumer(c <-chan int) {
    for i := 0; i < 10; i++ {
        v := <-c
        fmt.Println("receive:", v)
    }
}
func main() {
    ch := make(chan int)
    go produce(ch)
    go consumer(ch)
    time.Sleep(1 * time.Second)
}
在这段代码中,因为channel是没有缓冲的,所以当生产者给channel赋值后,生产者这个线程会阻塞,直到消费者线程将channel中的数据取出。消费者第一次将数据取出后,进行下一次循环时,消费者的线程也会阻塞,因为生产者还没有将数据存入,这时程序会去执行生产者的线程。程序就这样在消费者和生产者两个线程间不断切换,直到循环结束。
下面我们再看一个带缓冲的例子:
func produce(p chan<- int) {
    for i := 0; i < 10; i++ {
        p <- i
        fmt.Println("send:", i)
    }
}
func consumer(c <-chan int) {
    for i := 0; i < 10; i++ {
        v := <-c
        fmt.Println("receive:", v)
    }
}
func main() {
    ch := make(chan int, 10)
    go produce(ch)
    go consumer(ch)
    time.Sleep(1 * time.Second)
}
在这个程序中,缓冲区可以存储10个int类型的整数,在执行生产者线程的时候,线程就不会阻塞,一次性将10个整数存入channel,在读取的时候,也是一次性读取。
var quit chan int // 只开一个信道

func foo(id int) {
    fmt.Println(id)
    quit <- 0 // ok, finished
}

func main() {
    count := 1000
    quit = make(chan int) // 无缓冲

    for i := 0; i < count; i++ {
        go foo(i)
    }

    for i := 0; i < count; i++ {
        <- quit
    }
}
对于方案2, 把信道换成缓冲1000的:
quit = make(chan int, count) // 容量1000其实区别仅仅在于一个是缓冲的,一个是非缓冲的。 对于这个场景而言,两者都能完成任务, 都是可以的。
var quit chan int = make(chan int)

func loop() {
    for i := 0; i < 10; i++ {
        fmt.Printf("%d ", i)
    }
    quit <- 0
}


func main() {    // 开两个goroutine跑函数loop, loop函数负责打印10个数
    go loop()
    go loop()
    for i := 0; i < 2; i++ {
        <- quit
    }
}
输出结果:
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9这是不是有什么问题?? 以前我们用线程去做类似任务的时候,系统的线程会抢占式地输出, 表现出来的是乱序地输出。而goroutine为什么是这样输出的呢?
var quit chan int

func foo(id int) {
    fmt.Println(id)
    time.Sleep(time.Second) // 停顿一秒
    quit <- 0 // 发消息:我执行完啦!
}


func main() {
    count := 1000
    quit = make(chan int, count) // 缓冲1000个数据

    for i := 0; i < count; i++ { //开1000个goroutine
        go foo(i)
    }

    for i :=0 ; i < count; i++ { // 等待所有完成消息发送完毕。
        <- quit
    }
}
让我们跑一下这个程序(之所以先编译再运行,是为了让程序跑的尽量快,测试结果更好):
go build test.go
time ./test
./test 0.01s user 0.01s system 1% cpu 1.016 total
我们看到,总计用时接近一秒。 貌似并行了! 我们需要首先考虑下什么是并发, 什么是并行
import (
    "fmt"
    "runtime"
)

var quit chan int = make(chan int)

func loop() {
    for i := 0; i < 100; i++ { //为了观察,跑多些
        fmt.Printf("%d ", i)
    }
    quit <- 0
}

func main() {
    runtime.GOMAXPROCS(2) // 最多使用2个核
    go loop()
    go loop()
    for i := 0; i < 2; i++ {
        <- quit
    }
}
这下会看到两个goroutine会抢占式地输出数据了。
我们还可以这样显式地让出CPU时间:
func loop() {
    for i := 0; i < 10; i++ {
        runtime.Gosched() // 显式地让出CPU时间给其他goroutine
        fmt.Printf("%d ", i)
    }
    quit <- 0
}

func main() {
    go loop()
    go loop()
    for i := 0; i < 2; i++ {
        <- quit
    }
}
观察下结果会看到这样有规律的输出:
0 0 1 1 2 2 3 3 4 4 5 5 6 6 7 7 8 8 9 9其实,这种主动让出CPU时间的方式仍然是在单核里跑。但手工地切换goroutine导致了看上去的“并行”。
"world"呀,可是为什么什么也没有打印
func say(s string) {
    for i := 0; i < 5; i++ {
        fmt.Println(s)
    }
}

func main() {
    go say("world") //开一个新的Goroutines执行
    for {
    }
}
楼下的答案已经很棒了,这里Go仍然在使用单核,for死循环占据了单核CPU所有的资源,而main线和say两个goroutine都在一个线程里面, 所以say没有机会执行。解决方案还是两个:
runtime.GOMAXPROCS)runtime.Gosched)var quit chan int = make(chan int)
func loop(id int) { // id: 该goroutine的标号
for i := 0; i < 10; i++ { //打印10次该goroutine的标号
fmt.Printf("%d ", id)
}
quit <- 0
}
func main() {
runtime.GOMAXPROCS(2) // 最多同时使用2个核
for i := 0; i < 3; i++ { //开三个goroutine
go loop(i)
}
for i := 0; i < 3; i++ {
<- quit
}
}
多跑几次会看到类似这些输出(不同机器环境不一样):
0 0 0 0 0 1 1 0 0 1 0 0 1 0 1 2 1 2 1 2 1 2 1 2 1 2 2 2 2 2

0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2

0 0 0 0 0 0 0 1 1 1 1 1 0 1 0 1 0 1 2 1 2 1 2 2 2 2 2 2 2 2

0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 0 2 0 2 0 2 2 2 2 2 2 2 2

0 0 0 0 0 0 0 1 0 0 1 0 1 2 1 2 1 2 1 2 1 2 1 2 1 2 1 2 2 2
执行它我们会发现以下现象:
func main() {
    //创建一个goroutine
    go func(s string) {
        for i := 0; i < 2; i++ {
            fmt.Println(s)
        }
    }("world")

    for i := 0; i < 2; i++ {
        runtime.Gosched() //import "runtime"
        /*
            屏蔽runtime.Gosched()运行结果如下:
                hello
                hello
            没有runtime.Gosched()运行结果如下:
                world
                world
                hello
                hello
        */
        fmt.Println("hello")
    }
}
func main() {
    go func() {
        defer fmt.Println("A.defer")

        func() {
            defer fmt.Println("B.defer")
            runtime.Goexit() // 终止当前 goroutine, import "runtime"
            fmt.Println("B") // 不会执行
        }()

        fmt.Println("A") // 不会执行
    }() //别忘了()

    //死循环,目的不让主goroutine结束
    for {
    }
}
程序运行结果:
B.defer
A.defer
func main() {
    //n := runtime.GOMAXPROCS(1) //打印结果:111111111111111111110000000000000000000011111...
    n := runtime.GOMAXPROCS(2)     //打印结果:010101010101010101011001100101011010010100110...
    fmt.Printf("n = %d\n", n)

    for {
        go fmt.Print(0)
        fmt.Print(1)
    }
}
在第一次执行(runtime.GOMAXPROCS(1))时,最多同时只能有一个goroutine被执行。所以
会打印很多1。过了一段时间后,GO调度器会将其置为休眠,并唤醒另一个goroutine,这时候就开始打印很多0了,在打印的时候,goroutine是被调度到操作系统线程上的。
在第二次执行(runtime.GOMAXPROCS(2))时,我们使用了两个CPU,所以两个goroutine可以一起被执行,以同样的频率交替打印0和1。
    select {
    case <-chan1:
        // 如果chan1成功读到数据,则进行该case处理语句
    case chan2 <- 1:
        // 如果成功向chan2写入数据,则进行该case处理语句
    default:
        // 如果上面都没有成功,则进入default处理流程
    }
在一个select语句中,Go语言会按顺序从头至尾评估每一个发送和接收的语句。
如果其中的任意一语句可以继续执行(即没有被阻塞),那么就从那些可以执行的语句中任意选择一条来使用。
如果没有任意一条语句可以执行(即所有的通道都被阻塞),那么有两种可能的情况:
func fibonacci(c, quit chan int) {
    x, y := 1, 1
    for {
        select {
        case c <- x:
            x, y = y, x+y
        case <-quit:
            fmt.Println("quit")
            return
        }
    }
}

func main() {
    c := make(chan int)
    quit := make(chan int)

    go func() {
        for i := 0; i < 6; i++ {
            fmt.Println(<-c)
        }
        quit <- 0
    }()

    fibonacci(c, quit)
}
程序运行结果:
1
2
3
4
5
6
7
8
quit
2 超时 有时候会出现goroutine阻塞的情况,那么我们如何避免整个程序进入阻塞的情况呢?我们可以利用select来设置超时,通过如下的方式实现:
func main() {
    c := make(chan int)
    o := make(chan bool)
    go func() {
        for {
            select {
            case v := <-c:
                fmt.Println(v)
            case <-time.After(5 * time.Second):
                fmt.Println("timeout")
                o <- true
                break
            }
        }
    }()
    //c <- 666 // 注释掉,引发 timeout
    <-o
}
select有几个重要的点要强调:
1.如果有多个case都可以运行,select会随机公平地选出一个执行,其他不会执行
func main() {
    ch := make (chan int, 1)

    ch<-1
    select {
    case <-ch:
        fmt.Println("Good luck!")
    case <-ch:
        fmt.Println("Good day!")
    }
}
输出:
(随机)二者其一2.case后面必须是channel操作,否则报错。
func main() {
    ch := make (chan int, 1)
    ch<-1
    select {
    case <-ch:
        fmt.Println("Good luck!")
    case 2:
        fmt.Println("Good day!")
    }
}
输出报错:
2 evaluated but not used
select case must be receive, send or assign recv
3.select中的default子句总是可运行的。所以没有default的select才会阻塞等待事件
func main() {
    ch := make (chan int, 1)
    // ch<-1   <= 注意这里备注了。
    select {
    case <-ch:
        fmt.Println("Good luck!")
    default:
        fmt.Println("Good day!")
    }
}
输出:
Good day!4.没有运行的case,那么江湖阻塞事件发生报错(死锁)
func main() {
    ch := make (chan int, 1)
    // ch<-1   <= 注意这里备注了。
    select {
    case <-ch:
        fmt.Println("Good luck!")
    }
}
输出报错:
fatal error: all goroutines are asleep - deadlock!
func main() {
    timeout := make (chan bool, 1)
    go func() {
        time.Sleep(1*time.Second) // 休眠1s,如果超过1s还没I操作则认为超时,通知select已经超时啦~
        timeout <- true
    }()
    ch := make (chan int)
    select {
    case <- ch:
    case <- timeout:
        fmt.Println("超时啦!")
    }
}
以上是入门版,通常代码中是这么写的:
func main() {
    ch := make (chan int)
    select {
    case <-ch:
    case <-time.After(time.Second * 1): // 利用time来实现,After代表多少时间后执行输出东西
        fmt.Println("超时啦!")
    }
}
2.判断channel是否阻塞(或者说channel是否已经满了)
func main() {
    ch := make (chan int, 1)  // 注意这里给的容量是1
    ch <- 1
    select {
    case ch <- 2:
    default:
        fmt.Println("通道channel已经满啦,塞不下东西了!")
    }
}
3.退出机制
func main() {
    i := 0
    ch := make(chan string, 0)
    defer func() {
        close(ch)
    }()

    go func() {
        DONE:
        for {
            time.Sleep(1*time.Second)
            fmt.Println(time.Now().Unix())
            i++

            select {
            case m := <-ch:
                println(m)
                break DONE // 跳出 select 和 for 循环
            default:
            }
        }
    }()

    time.Sleep(time.Second * 4)
    ch<-"stop"
}
输出:
1532390471
1532390472
1532390473
stop
1532390474
这边要强调一点:退出循环一定要用break + 具体的标记,或者goto也可以。否则其实不是真的退出。
func main() {
    i := 0
    ch := make(chan string, 0)
    defer func() {
        close(ch)
    }()

    go func() {

        for {
            time.Sleep(1*time.Second)
            fmt.Println(time.Now().Unix())
            i++

            select {
            case m := <-ch:
                println(m)
                goto DONE // 跳出 select 和 for 循环
            default:
            }
        }
        DONE:
    }()

    time.Sleep(time.Second * 4)
    ch<-"stop"
}
输出:
1532390525
1532390526
1532390527
1532390528
stop
9.select死锁 select不注意也会发生死锁,前文有提到一个,这里分几种情况,重点再次强调: 1.如果没有数据需要发送,select中又存在接收通道数据的语句,那么将发送死锁
func main() {
    ch := make(chan string)
    select {
    case <-ch:
    }
}
预防的话加default。
空select,也会引起死锁
package main

func main() {
    select {}
}
func main() {
    tick := time.Tick(100 * time.Millisecond)
    boom := time.After(500 * time.Millisecond)
    for {
        select {
        case t := <-tick:
            fmt.Println("tick.", t)
        case t := <-boom:
            fmt.Println("BOOM!")
            return
//      default:
//          fmt.Println("    .")
//          time.Sleep(50 * time.Millisecond)
        }
    }
}
加 default 和 不加 default 的区别?…
时间事件是 goroutine 的最重要事件源之一!
sync 库
Mutex :互斥量。
WaitGroup:信号量
Cond:带锁的通知量
Once 确保函数线程安全地仅只执行一次。(做单实例的神器)
3 集合类型都不是线程安全的
slice
map
package main

import (
    "fmt"
    "sync"
)

func main() {

    var wg sync.WaitGroup

    wg.Add(2) // 因为有两个动作,所以增加2个计数
    go func() {
        fmt.Println("Goroutine 1")
        wg.Done() // 操作完成,减少一个计数
    }()

    go func() {
        fmt.Println("Goroutine 2")
        wg.Done() // 操作完成,减少一个计数
    }()

    wg.Wait() // 等待,直到计数为0
}
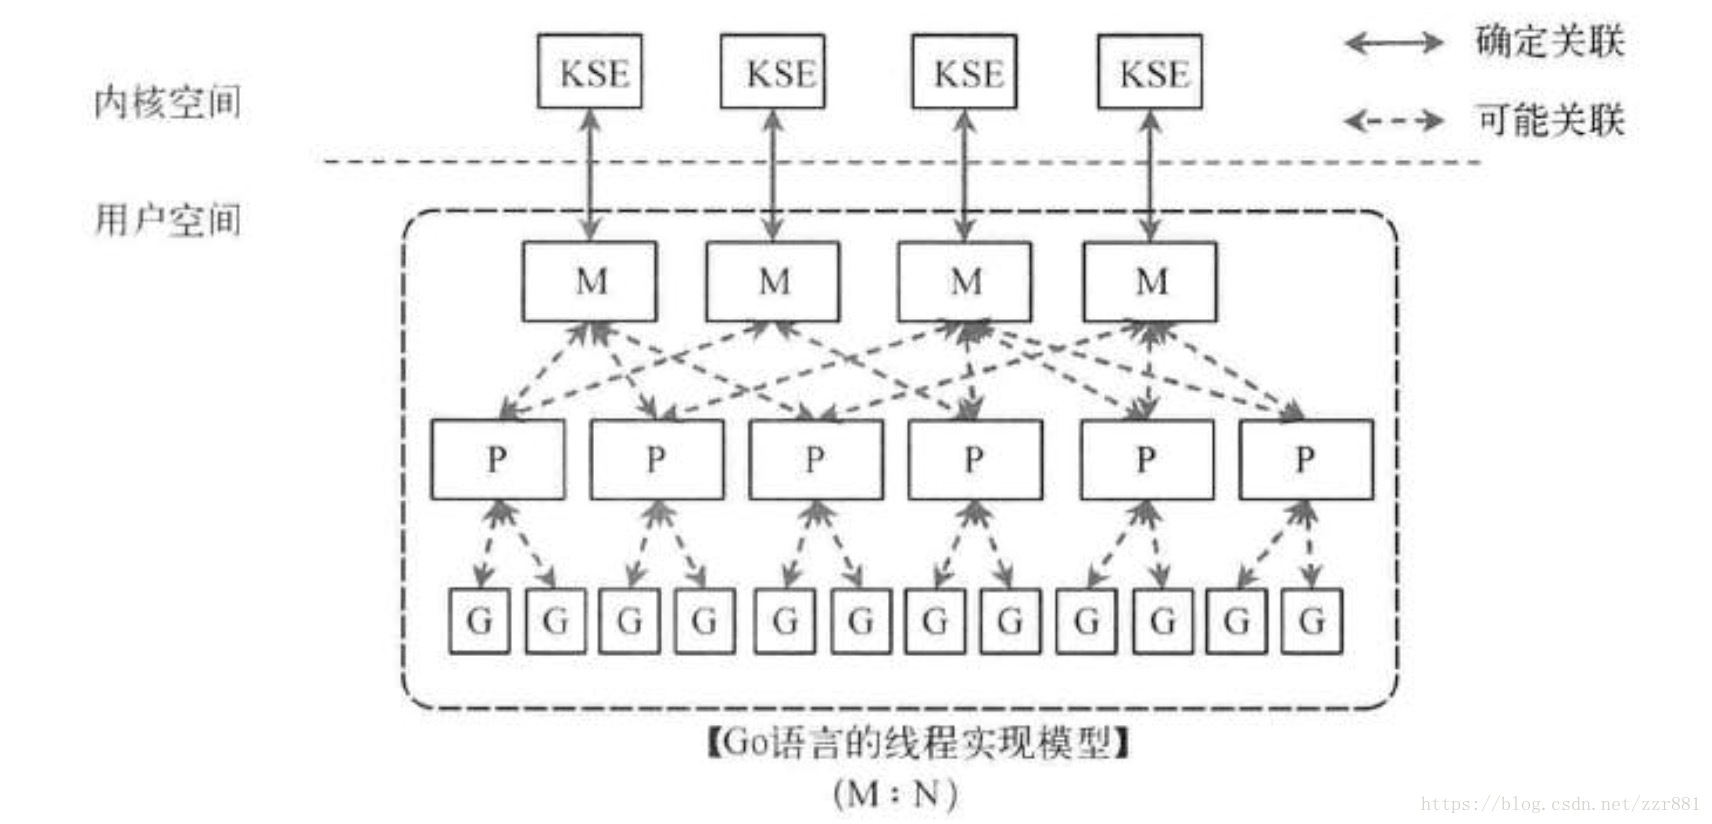 我个人的理解:M关联了一个内核线程,通过调度器P(上下文)的调度,可以连接1个或者多个G,相当于把一个内核线程切分成了了N个用户线程,M和P是一对一关系(但是实际调度中关系多变),通过P调度N个G(P和G是一对多关系),实现内核线程和G的多对多关系(M:N),通过这个方式,一个内核线程就可以起N个Goroutine,同样硬件配置的机器可用的用户线程就成几何级增长,并发性大幅提高。
当我们需要在Go语言中复制一个切片时,我们可以使用内置的copy函数。copy函数可以将一个切片的元素复制到另一个切片中。下面是一个示例: 在上面的示例中,我们首先创建了一个源切片

树结构实现,可以根据具体需求进行扩展和定制。树结构是一种非常常见的数据结构,用于表示层次关系和组织结构。在实际应用中,树结构可以用于构建文件系统、表示组织结构、实现算法和数据结构等

读取后缀ini的配置文件,读取文件比较好配置,主要是读取的文件路径,如果找不到文件的路径可以使用os模块,打印出文件的当前路径,然后在配置当前路径下的绝对路径即可。可以参考: 先创
评论 0