云原生
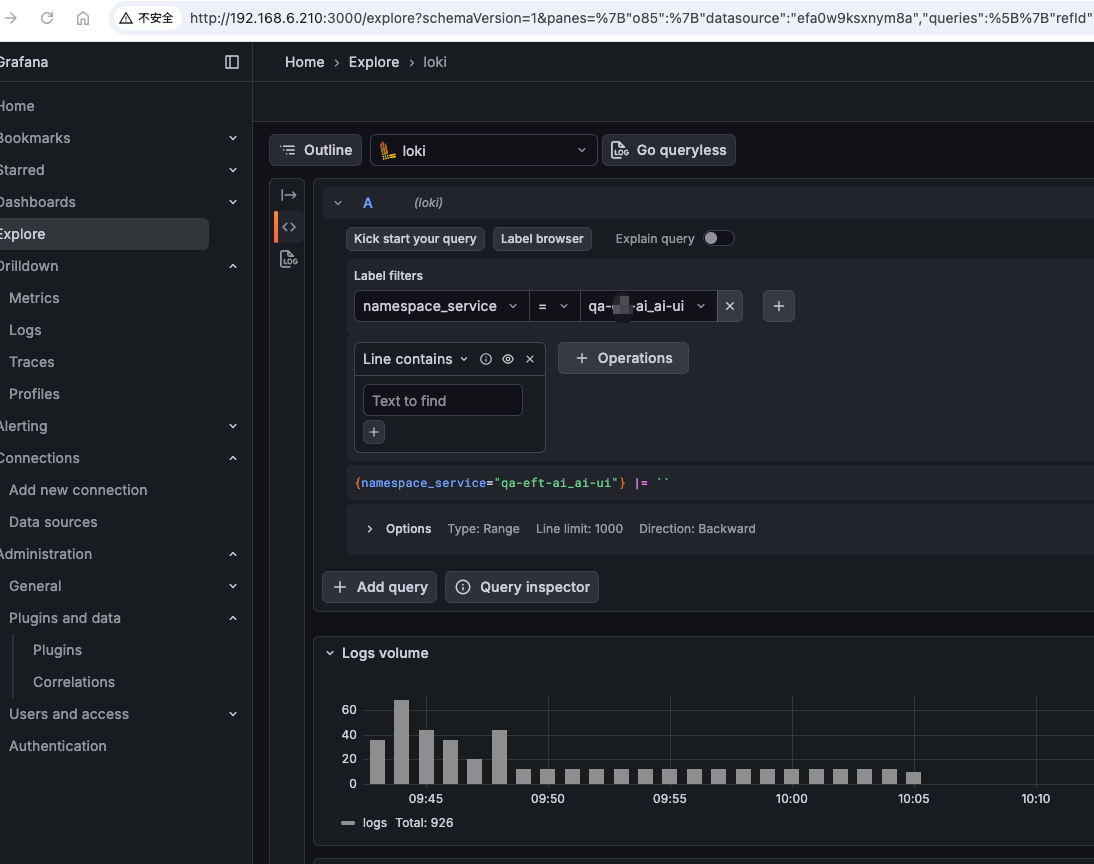
利用kurise做日志采集使用promtail做sidecar采集日志
利用OpenKurise中的kruise做日志采集,原来我使用的是filebeat作为sidecar采集日志的,虽然采集没有什么问题,但是通过es进才看日志就比较繁琐了,这次实验p
做 Kubernetes 运维,有一种问题不一定每天出现,但一旦出现就挺麻烦:应用运行得好好的,过几天或者过一段时间,Pod 开始重启。查业务代码没发现明显异常,内存也没到上限,最后一看,问题可能出在日志上。
尤其是 Java / Spring Boot 应用,日志一直往容器内部的文件里写,app.log 越来越大。刚开始几百 MB,后来几个 GB,时间长了就可能把容器可写层或者节点磁盘拖到高水位,最终影响业务运行。
我在排查这类问题时,最容易遇到的一个误区就是:既然日志占空间,那我给它限制一个大小不就行了?
事情没这么简单。限制空间和日志轮转是两回事,Kubernetes 管理容器标准输出日志的机制,也不等于会自动管理应用自己写出来的日志文件。
这篇就从实际运维场景出发,把排查方法和改造思路整理一下。
假设我们的环境是:
这种架构下,应用日志文件持续增长,确实可能导致容器可写层或节点磁盘压力增大。但先别急着修改配置,第一步还是要确认重启原因。
先查看 Pod:
kubectl get pods -A \
  -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,RESTARTS:.status.containerStatuses[*].restartCount,NODE:.spec.nodeName'
找到异常 Pod 后:
NS=你的命名空间
POD=你的Pod名称

kubectl describe pod "$POD" -n "$NS"
再把上一次容器的退出信息单独拉出来:
kubectl get pod "$POD" -n "$NS" \
  -o jsonpath='{range .status.containerStatuses[*]}{"容器: "}{.name}{" 原因: "}{.lastState.terminated.reason}{" 退出码: "}{.lastState.terminated.exitCode}{" 重启次数: "}{.restartCount}{"\n"}{end}'
主要关注几个情况:
OOMKilled:容器因为内存超限被杀,不能直接归因于日志磁盘问题。Error:应用异常退出,需要结合退出码和应用日志判断。Evicted:Pod 被驱逐,要检查节点磁盘压力和临时存储限制。no space left on device:需要进一步确认是磁盘空间还是 inode 耗尽。再看一下上一次容器的输出:
kubectl logs "$POD" -n "$NS" --previous --tail=200
这里要注意,kubectl logs 主要查看容器的 stdout/stderr。如果 Java 应用把日志写进 /app/logs/app.log,这些文件内容未必能通过这个命令看到。
所以,排查不能只盯着 Pod 状态,还得进入容器检查实际日志目录。
这个问题得先区分日志写在哪里。
如果应用输出到 stdout/stderr,containerd 会把标准输出日志写到节点上的日志文件,由 kubelet 负责日志轮转。
但如果应用直接把日志写入:
/app/logs/app.log
这个文件通常位于容器的可写层。Kubernetes 对标准输出日志的轮转配置,不会自动限制这个文件的大小。
比如,你在 kubelet 中设置了:
containerLogMaxSize: 50Mi
containerLogMaxFiles: 5
这控制的是容器标准输出日志文件的轮转,不是 /app/logs/app.log。
同样,给 Pod 配置 ephemeral-storage 限制,也不是让应用日志达到阈值后自动切分。超出相关限制时,Pod 可能被驱逐;节点发生磁盘压力时,也可能影响其他业务。
官方文档对此有明确说明:kubelet 负责容器日志轮转,默认单个日志文件大小为 10Mi,默认保留 5 个文件。这里管理的是容器日志,而不是应用自己写入任意目录的文件。
参考:Kubernetes 官方文档《Logging Architecture》。
先找到 Pod 所在节点:
NODE=$(kubectl get pod "$POD" -n "$NS" \
  -o jsonpath='{.spec.nodeName}')

echo "$NODE"
登录这个节点,查看磁盘和 inode:
df -hT
df -ih
再看看日志目录占用了多少空间:
du -x -h --max-depth=1 /var/log 2>/dev/null | sort -h

du -x -h --max-depth=1 /var/log/pods 2>/dev/null | sort -h
如果怀疑容器运行时目录占用过大,再检查:
du -x -h --max-depth=1 /var/lib/containerd 2>/dev/null | sort -h
注意,containerd 目录里不只有日志,还有镜像、快照和其他运行时数据,不要直接删除里面的文件。
然后进入业务容器检查日志目录:
kubectl exec -n "$NS" "$POD" -- sh -c '
  df -h
  df -i
  du -x -h --max-depth=2 /app/logs 2>/dev/null | sort -h | tail -30
'
把 /app/logs 换成实际路径。
如果发现 app.log 已经很大,或者目录下积累了大量历史文件,基本就找到需要处理的地方了。
还有一个容易忽略的情况:文件已经删除,但进程仍然持有它的文件句柄。这时 du 看不到文件,磁盘空间却没有释放。可以在节点上检查:
lsof +L1
如果没有这个命令,可以先跳过,别为了排查影响生产业务。
如果暂时不准备修改整个日志架构,我建议先把应用日志轮转做好。
Spring Boot 默认通常使用 Logback,但也可能换成 Log4j2,或者通过自定义配置文件控制日志。所以先确认实际使用的框架。
有源码的话,可以检查 Maven 依赖:
mvn dependency:tree | grep -Ei 'spring-boot|logback|log4j'
如果使用 Gradle:
./gradlew dependencies | grep -Ei 'spring-boot|logback|log4j'
假设使用的是支持相应配置属性的 Spring Boot + Logback,可以在 application.yml 中配置:
logging:
  file:
    name: /app/logs/app.log
  logback:
    rollingpolicy:
      file-name-pattern: /app/logs/app.%d{yyyy-MM-dd}.%i.log.gz
      max-file-size: 100MB
      max-history: 7
      total-size-cap: 1GB
这套配置的目的很简单:
这里的 100MB、7 天和 1GB 都只是示例,实际要根据日志产生速度、排障需要和磁盘容量调整。
另外,如果项目已经有 logback-spring.xml,要检查它是否定义了自己的 Appender 和 RollingPolicy。自定义配置可能覆盖 Spring Boot 的默认行为,不能只把 YAML 加进去就认为一定生效。
还要记住,total-size-cap 不是整个目录的硬容量上限,不能代替磁盘监控。
只给 Java 日志加轮转还不够。
我们的日志链路是:
Java 日志文件
      ↓
Filebeat Sidecar
      ↓
Kafka
      ↓
Logstash
      ↓
Elasticsearch
这里至少有三个问题需要考虑。
第一,Filebeat 可能因为 Kafka 暂时不可用而积压日志。
第二,Sidecar 随着业务 Pod 重建时,如果采集状态和待发送事件只保存在容器文件系统中,就可能丢失进度或积压数据。
第三,Filebeat 即使启用了磁盘队列,也不能无限缓存。队列达到容量上限后,下游如果一直不可用,仍然会出现积压风险。
因此,我建议至少做好两件事:把 Filebeat 的数据目录放在可靠的持久化存储上,并启用磁盘队列。
例如,Filebeat 8.x 可以参考下面的配置:
path.data: /usr/share/filebeat/data

queue.disk:
  path: /usr/share/filebeat/data/diskqueue
  max_size: 5GB
  segment_size: 100MB
这里的 5GB 是示例值。真正上线之前,要根据每天的日志量、Kafka 故障持续时间和可用磁盘空间计算。
例如,假设日志平均每秒产生 2MB,那么一小时就可能产生约 7.2GB 日志。此时配置 5GB 的队列,显然不足以应对一小时的下游故障。
还需要注意:path.data 不能只存在于 Filebeat 容器自己的可写层中。否则 Sidecar 重建后,持久化队列和采集状态仍可能丢失。
如果 Java 使用 Logback 生成如下文件:
app.log
app.2026-10-15.0.log.gz
app.2026-10-15.1.log.gz
Filebeat 必须能读取活动文件以及需要采集的归档文件。
一个配置示例:
filebeat.inputs:
  - type: filestream
    id: java-app-log
    enabled: true
    paths:
      - /app/logs/app.log
      - /app/logs/app.*.log.gz
    compression: auto
这里的 id 应保持稳定,不要随意修改;修改后可能导致重新采集,出现重复日志。
还要留意轮转策略。Filebeat 官方文档建议采集路径覆盖活动文件和轮转文件,并指出某些轮转方式可能产生丢失或重复事件。特别是 copytruncate,在复制与截断之间存在日志丢失风险。
参考:Elastic 官方文档《Log rotation results in lost or duplicate events》。
所以,日志轮转不能只看文件是否切分,还要验证 Filebeat 是否完整读到了归档文件。
Filebeat 端做好缓冲之后,还要考虑 Kafka。
对于关键日志 Topic,可以考虑:
replication.factor = 3
min.insync.replicas = 2
Filebeat required_acks = -1
这组配置的前提是 Kafka 集群确实有足够的 Broker,并且 Topic 的副本已经正确分配。
required_acks: -1 表示生产者等待当前所有同步副本确认;min.insync.replicas: 2 则要求至少有两个同步副本,才能满足写入条件。
这样可以降低单个 Broker 故障导致日志丢失的风险。
但有一点必须说明:Kafka 的可靠性配置只能保护已经成功写入 Kafka 的数据。尚未被 Filebeat 发送的日志,仍然依赖源文件、Filebeat 队列和本地磁盘。
另外,Kafka 的保留时间也要按日志量规划。如果积压日志还没被 Logstash 消费,Topic 中的数据就已经过期,后面的链路再可靠也没用。
如果问我,这个问题最终应该怎么治理,我更倾向于把 Filebeat 改为 DaemonSet,统一采集节点上的容器日志。
架构变成:
Java / Spring Boot
        ↓
stdout / stderr
        ↓
containerd 节点日志文件
        ↓
kubelet 负责日志轮转
        ↓
Filebeat DaemonSet
        ↓
Kafka
        ↓
Logstash
        ↓
Elasticsearch
为什么更倾向于这种方式?
因为 Sidecar 跟着业务 Pod 一起创建和销毁。业务容器重建时,采集器也可能跟着重建;而 DaemonSet 的 Filebeat 独立于业务 Pod 的生命周期,能够统一采集节点上的容器日志。
另外,stdout/stderr 不需要应用自己不断维护一个巨大的日志文件。kubelet 会负责标准输出日志的轮转,Filebeat 再负责读取和转发。
不过,这不意味着 stdout 绝对不会丢日志。
如果节点突然损坏、日志文件轮转过快、Filebeat 积压过久,仍然可能出现日志缺口。节点日志轮转容量也不能设置得过小,否则采集器还没读完,旧文件就可能被清理。
因此,改成 DaemonSet 后,还要做好节点磁盘监控、轮转容量规划、Filebeat 磁盘队列和 Kafka 副本配置。
不要只看应用启动成功就算改造完成。
建议找一个测试业务,逐项验证:
测试时可以给每条日志加一个唯一序号,例如:
TEST-000001
TEST-000002
TEST-000003
最后在 Kafka 端统计缺失序号和重复序号。因为日志链路可能采用至少一次投递机制,所以单纯比较总条数不够。
还要设置监控,至少关注:
DiskPressure 状态。容器日志问题,不能只靠把空间调大来解决。空间调大,只是让问题晚一点出现;没有轮转和清理机制,日志迟早还会增长到新的上限。
对于已经使用 K8s、containerd、Filebeat 和 Kafka 的环境,我会先给 Java 日志加原生轮转,再把 Filebeat 的状态和队列持久化,确认采集链路可靠后,逐步改为 stdout/stderr 加 DaemonSet 采集。
这样做的目的不是追求某一种架构有多先进,而是把业务运行、日志存储和日志采集分开管理。日志再多,也不应该因为一个不断增长的文件,就让整个业务跟着受影响。
当然,任何日志链路都无法在所有故障场景下保证绝对不丢。如果是资金、交易或审计类关键记录,仍然应该在业务层使用可靠的持久化机制,而不是把普通运行日志当作唯一的数据保障。
利用OpenKurise中的kruise做日志采集,原来我使用的是filebeat作为sidecar采集日志的,虽然采集没有什么问题,但是通过es进才看日志就比较繁琐了,这次实验p
RBAC(RoleBased Access Control)是 Kubernetes 中最核心、最常用的权限控制模型。无论你是平台管理员、SRE,还是 K8s 应用开发者,只要你需
在 Kubernetes 环境下,通过 Filebeat 采集容器日志并将其转发至日志平台(如 Kafka、Elasticsearch)是一种常见的日志解决方案。为了实现日志的可观
评论 0