
运维监控
nagios配置报警方法
原理 Nagios的报警原理可以概括为以下几个步骤: 1. 监测主机和服务状态:Nagios通过周期性地执行预定义的监测命令,检查被监控主机和服务的状态。这些监测命令可以是Ping
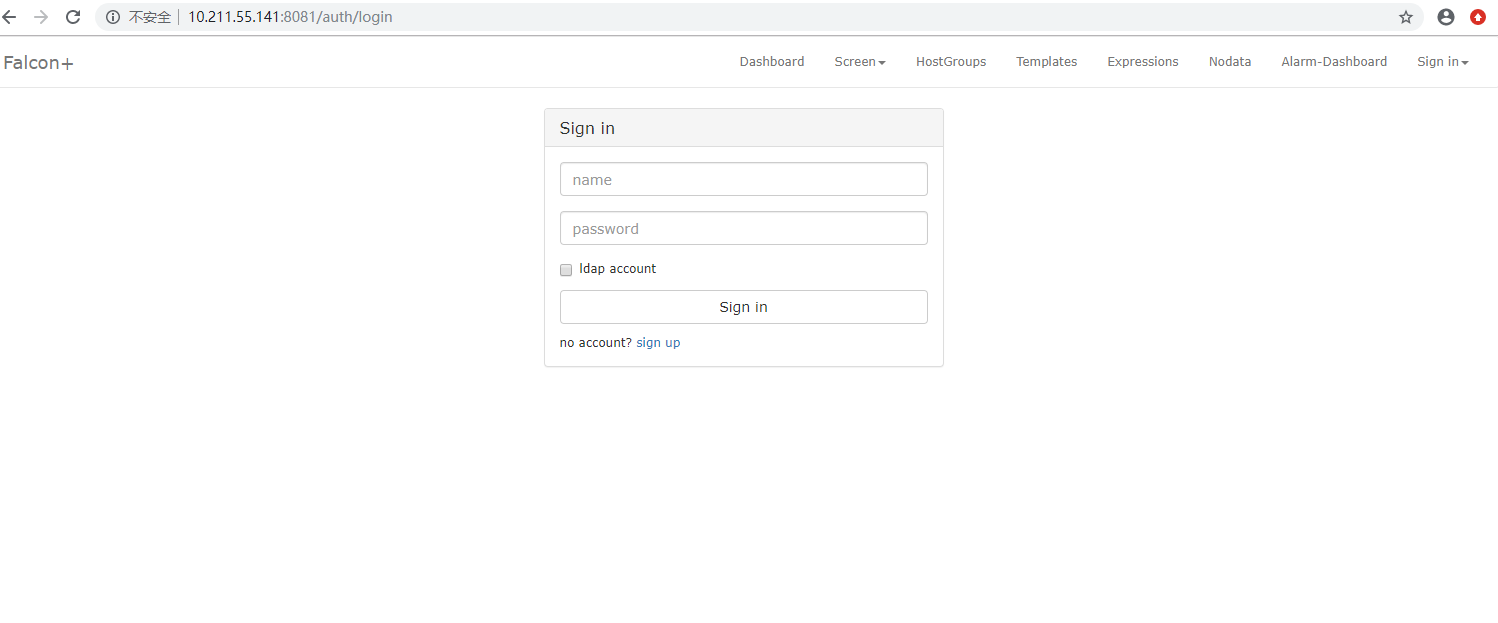 注册好管理员,我们先看一下我们的客户端是否已经能够正常发送监控数据给服务端
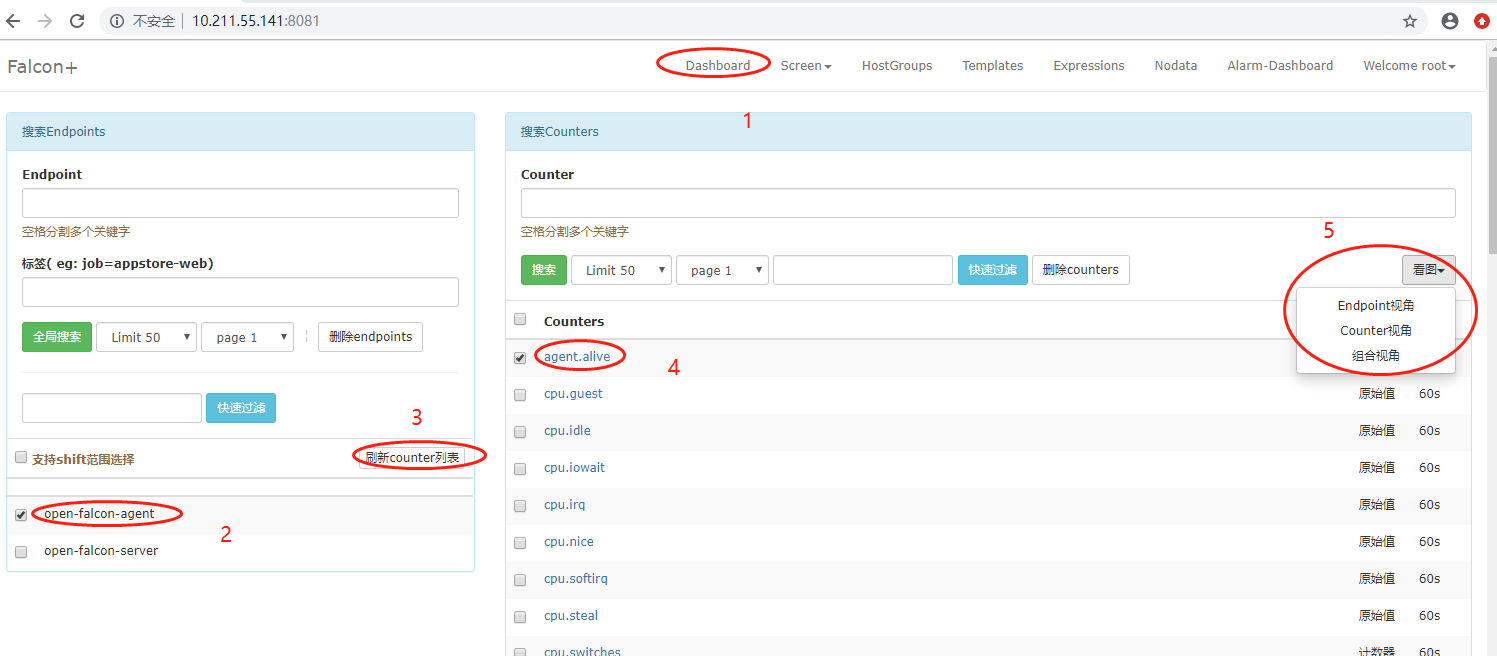 在5看图里有三种看图方式有兴趣的了解一下,不同的组合方式都会有监控数据产生。这里就不多数据了,下面说一下创建模板。
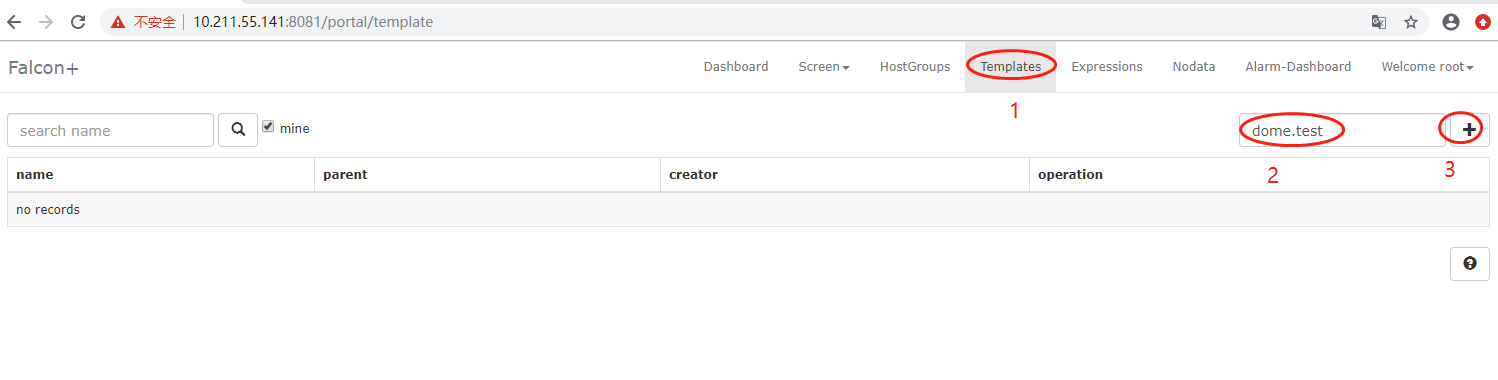 这样一个简单的模板创建成了,模板创建的只是一个名称,并没有给模板中的一些关键信息设置报警阈值,我这里先创建了一个端口的监控,因为端口有很多个,我在tags中注明是监控的80端口,创建cpu.user的时候没有注明,设置的cpu报警值有点低,主要为了后面的报警。
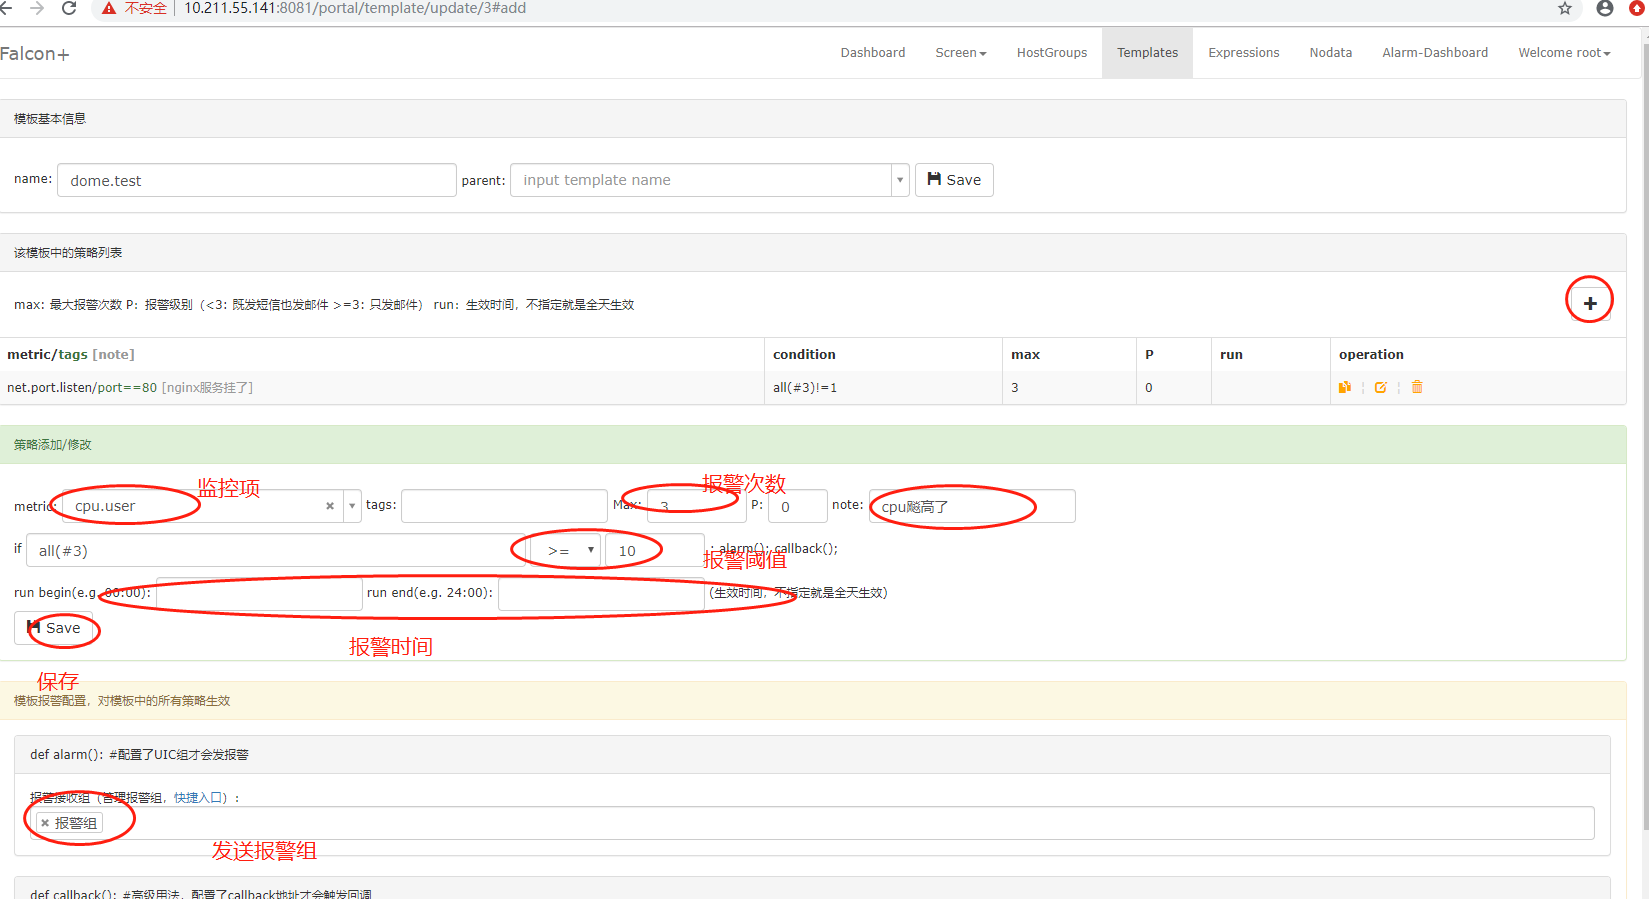 设置之后保存,目前先设置这两个,然后把报警组件进来,这里callback地址就不先做了,保存。
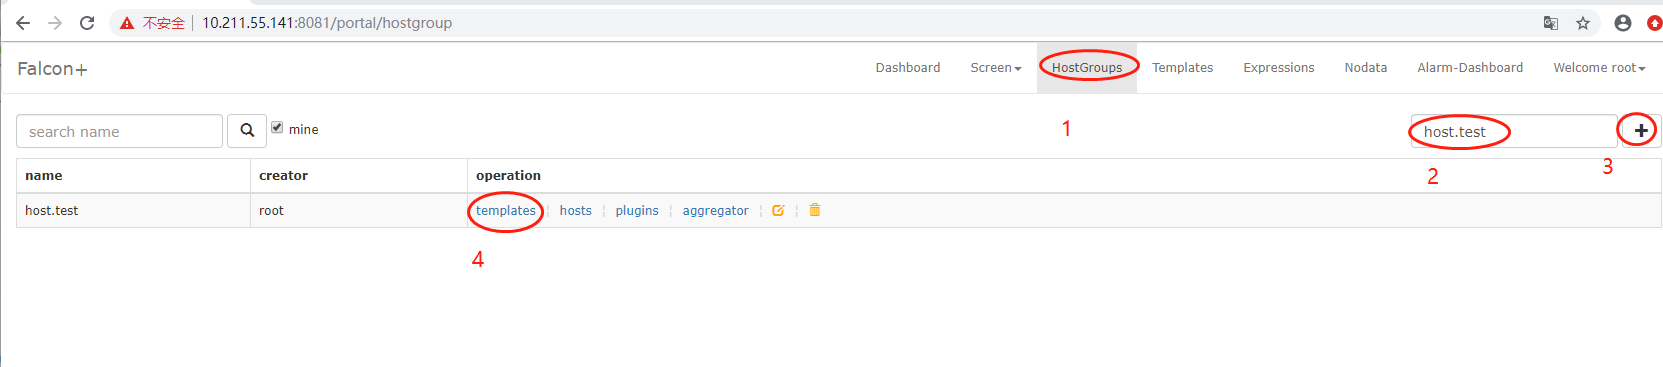 点击4后,把新建的模板名称加到input template name中然后点击一下+Bind,这里host组就关联模板,host组中模板定义的监控项就会触发报警了。还需要4后面的hosts中---+Add Host然后把计算机名粘贴进去,保存添加完成。
我先在客户端上操作一下,让cpu跑起来,才能触发报警,看一下我的命令
[root@open-falcon-agent config]# for i in seq 1 100 ;do dd if=/dev/zero of=/dev/null;done等一会,看一下Open-Falcon是否有报警出现,报警信息在Alarm-Dashboard里看下面的截图
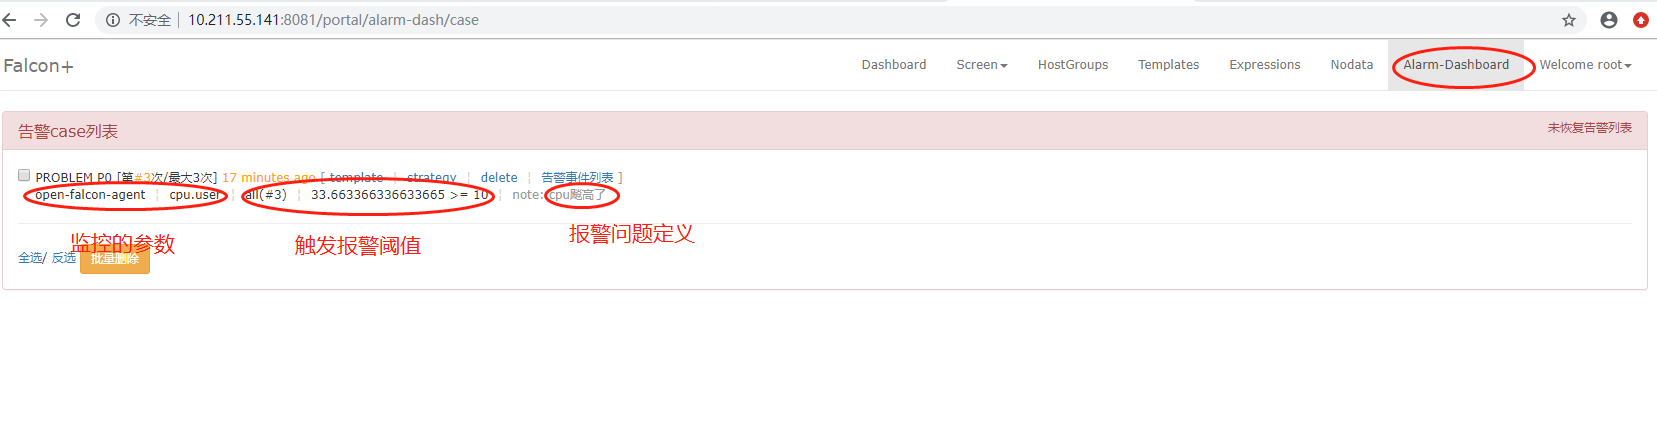 目前,Open-Falcon的自动报警配置完成,第三方报警方式,敬请期待下章文章描述。
原理 Nagios的报警原理可以概括为以下几个步骤: 1. 监测主机和服务状态:Nagios通过周期性地执行预定义的监测命令,检查被监控主机和服务的状态。这些监测命令可以是Ping
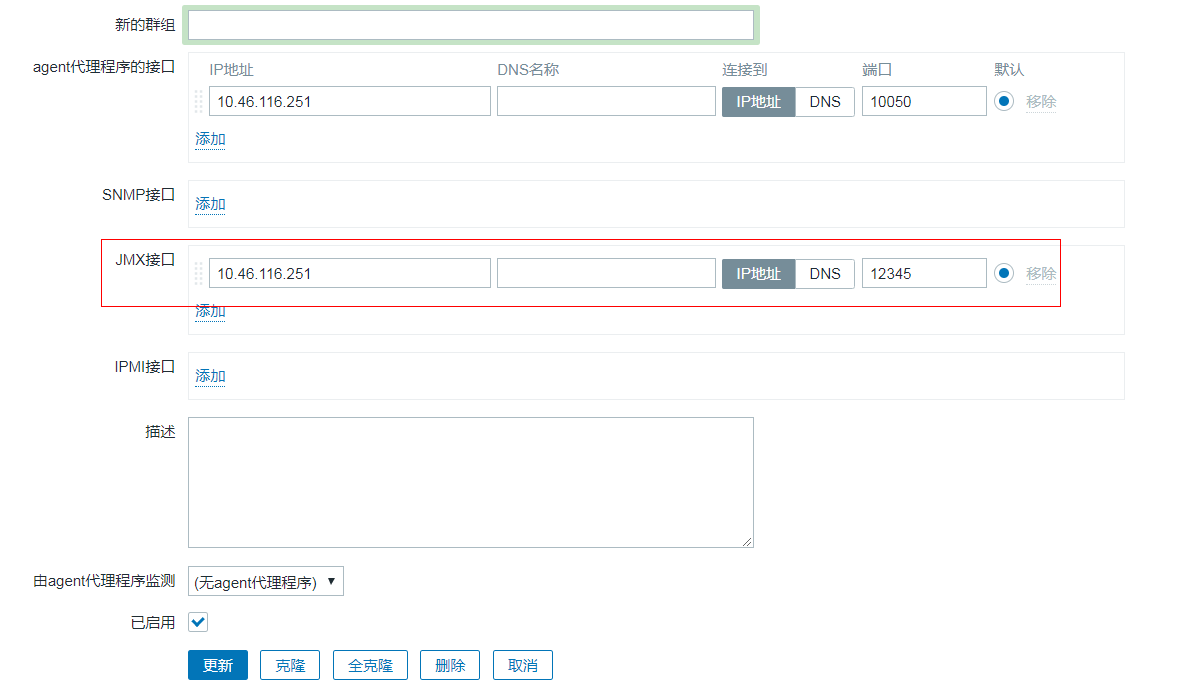
概述 使用java语言开发的情况下,需要监控java的jvm性能等需求。 需要组件 系统:ubuntu16.04 基础组件参照:zabbixmysql5.7、zabbixserve
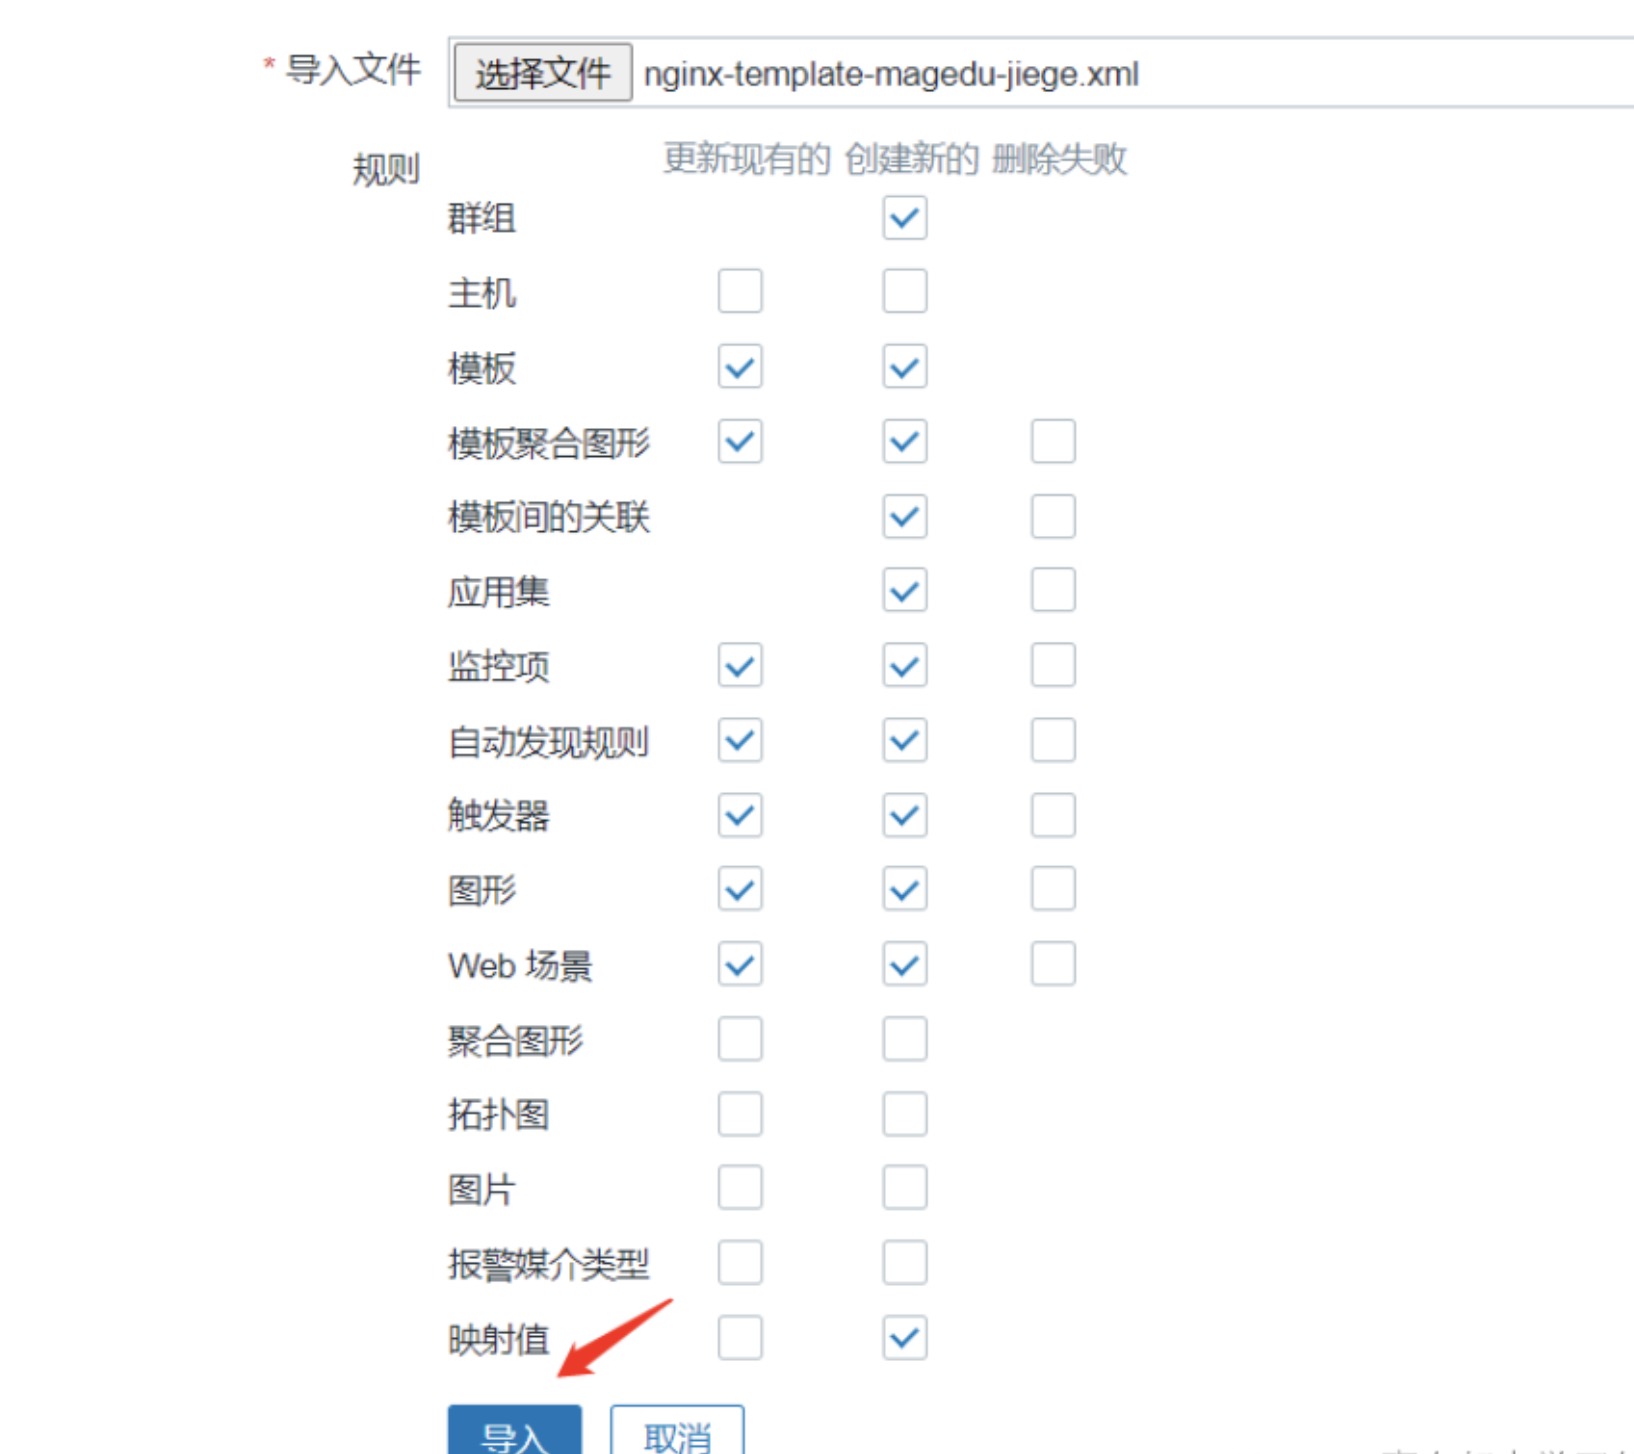
环境准备 五台机器: zabbix\agent 5.0 被动模式(已安装) Zabbix\java\gateway 5.0 (已安装) 10.0.0.7 MariaDB10.4.2
评论 0