数据库
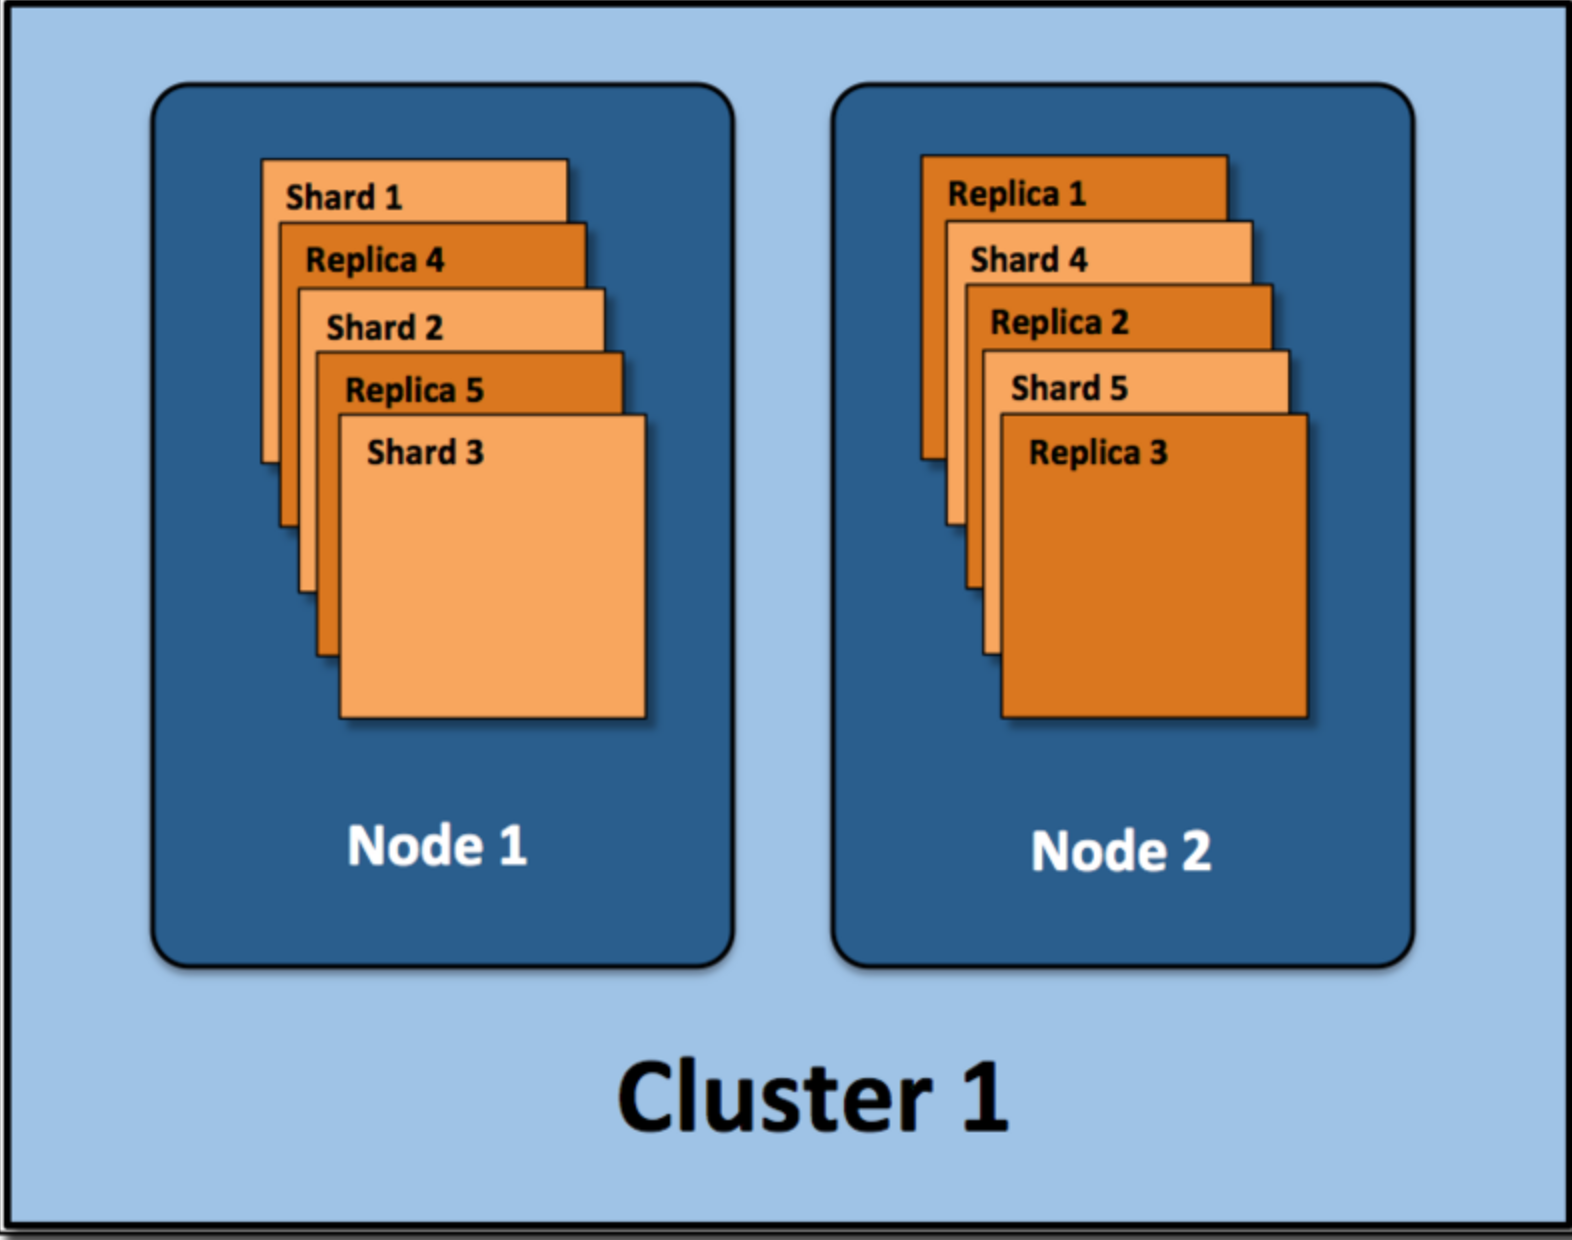
ElasticSearch 如何合理分配索引分片
Elasticsearch 是一个非常通用的平台,支持各种用户实例,并为组织数据和复制策略提供了极大的灵活性。但是,这种灵活性有时会使我们很难在早期确定如何很好地将数据组织成索引和
 推荐
玩了几年kubernetes,但是针对kubernetes的工具,推荐几个个人认为还算不错的工具。这里的工具主要是通过平台来管理kubernetes,方便给不太了解k8s的同学或者
 推荐
我们继续上一章的,点击开始后进入这个页面,会有一个欢迎视频,可以忽略点击底部的跳过,然后要求上传个人头像,这里也跳过,需要创建一个空间,这里我们创建运维部,开发部,产品部,测试部等
 推荐
安装gitlab时,使用rpm安装,提示错误: 这个错误提示,是因为gitlab安装时需要依赖policycoreutilspython。所以需要先安装policycoreutil
 推荐
kubernetes中rollout命令主要是针对资源进行管理,比如服务回滚,服务暂停,资源状态,查看历史等等。不过这里用的比较多的就是回滚版本,暂停资源,重新部署等下,下面看看在
 MySQL
ProxySQL / dble / MHA 的选型、配置与生产踩坑记录。
12 篇 · 更新于 2026-07 Kubernetes
日志采集、监控告警、RBAC、探针与调度的一线经验。
18 篇 · 更新于 2026-01 可观测性
Prometheus + Grafana + Loki 从部署到告警规则。
9 篇 · 更新于 2025-12MySQLProxySQL / dble / MHA 的选型、配置与生产踩坑记录。
12 篇 · 更新于 2026-07Kubernetes日志采集、监控告警、RBAC、探针与调度的一线经验。
18 篇 · 更新于 2026-01可观测性Prometheus + Grafana + Loki 从部署到告警规则。
9 篇 · 更新于 2025-12Elasticsearch 是一个非常通用的平台,支持各种用户实例,并为组织数据和复制策略提供了极大的灵活性。但是,这种灵活性有时会使我们很难在早期确定如何很好地将数据组织成索引和
一个适当配置的Mongodb分片集群是没有单点故障。 本文描述了分片集群中存在的几种不同的潜在的节点故障场景,以及Mongodb对这些节点故障是怎么处理的。 1、Mongos节点宕
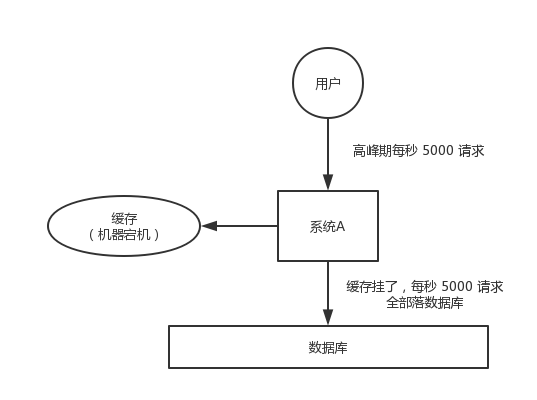
缓存雪崩 对于系统 A,假设每天高峰期每秒 5000 个请求,本来缓存在高峰期可以扛住每秒 4000 个请求,但是缓存机器意外发生了全盘宕机。缓存挂了,此时 1 秒 5000 个请
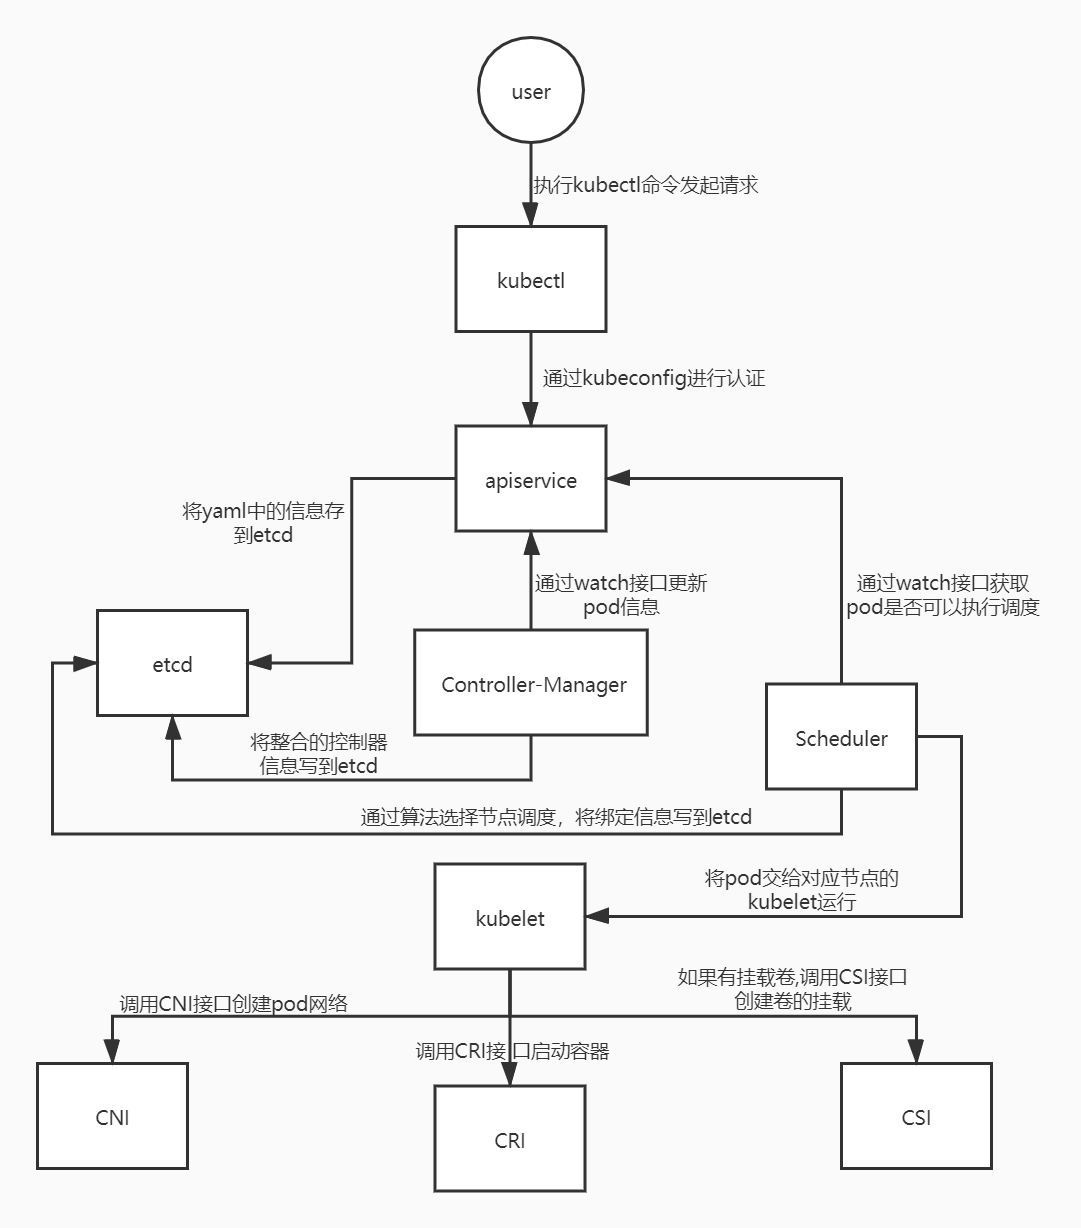
在kubernetes中,pod是最小的单元,如何理解最小单元,就比如我们说的人民币,人民币的最新单元是多少,厘,厘是人民币的最小单元,虽然现在很少了,但是也是有的,pod就相当于
方法1: 直接使用数据库提供的SQL语句 语句样式: MySQL中,可用如下方法: SELECT \ FROM 表名称 LIMIT M,N 适应场景: 适用于数据量较少的情况元组百
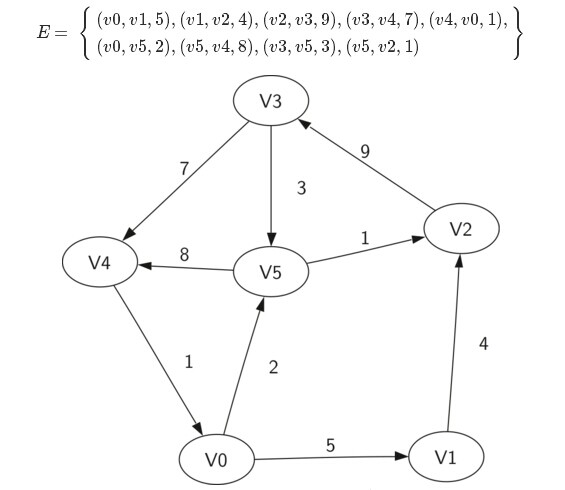
一个图graphG=V,E是由顶点集V和边集E组成。每一条边就是一个顶点对v,w,其中v,w∈V。如果点对是有序的,那么图就是有向图。 图中的一条路径path是一个顶点序列w1,w
很多人说在北京压力大,北京的生活消费水平比较高,这里写一下我的个人观点,记得刚来北京那会,一个月的公司四千多,租的房子就在公司对面,房租一千五,因为公司所在位置比较偏僻,所以租的房
散列表的实现常常叫做散列hashing。散列仅支持INSERT,SEARCH和DELETE操作,都是在常数平均时间执行的。需要元素间任何排序信息的操作将不会得到有效的支持。 散列表