云原生
利用kurise做日志采集使用promtail做sidecar采集日志
利用OpenKurise中的kruise做日志采集,原来我使用的是filebeat作为sidecar采集日志的,虽然采集没有什么问题,但是通过es进才看日志就比较繁琐了,这次实验p
apiVersion: v1
kind: Service
metadata:
  labels:
    name: mysql
    role: service
  name: mysql-service
spec:
  ports:
    - port: 3306
      targetPort: 3306
      nodePort: 30964
  type: NodePort
  selector:
    mysql-service: "true"
上面配置的含义是在node上暴露出30964端口。当访问node上的30964端口时,其请求会转发到service对应的cluster IP的3306端口,并进一步转发到pod的3306端口。
Service, Endpoints与Pod的关系
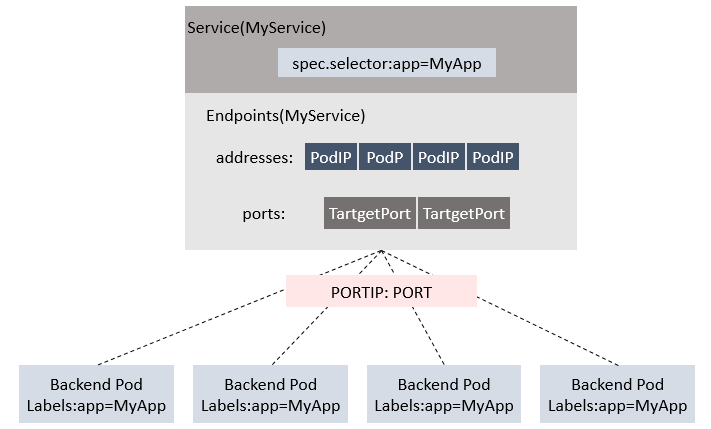 Kube-proxy进程获取每个Service的Endpoints,实现Service的负载均衡功能
Service的负载均衡转发规则
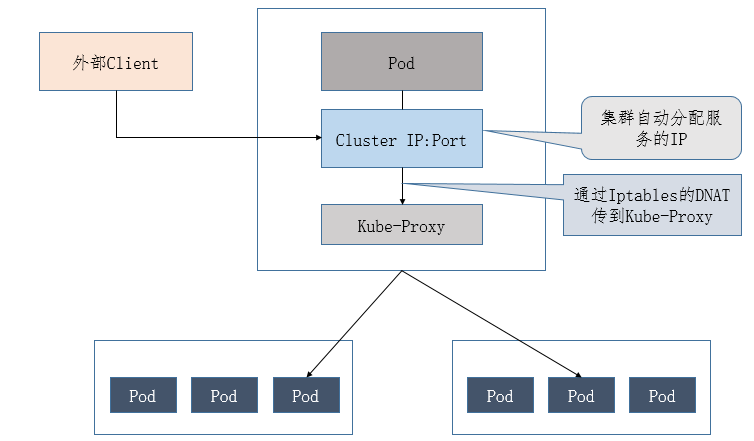 访问Service的请求,不论是Cluster IP+TargetPort的方式;还是用Node节点IP+NodePort的方式,都被Node节点的Iptables规则重定向到Kube-proxy监听Service服务代理端口。kube-proxy接收到Service的访问请求后,根据负载策略,转发到后端的Pod。
REDIS_MASTER_SERVICE_HOST=172.16.50.11
REDIS_MASTER_SERVICE_PORT=6379
REDIS_MASTER_PORT=tcp://172.16.50.11:6379
REDIS_MASTER_PORT_6379_TCP=tcp://172.16.50.11:6379
REDIS_MASTER_PORT_6379_TCP_PROTO=tcp
REDIS_MASTER_PORT_6379_TCP_PORT=6379
REDIS_MASTER_PORT_6379_TCP_ADDR=172.16.50.11
2) DNS:这是k8s官方强烈推荐的方式!!! 可以通过cluster add-on方式轻松的创建KubeDNS来对集群内的Service进行服务发现。
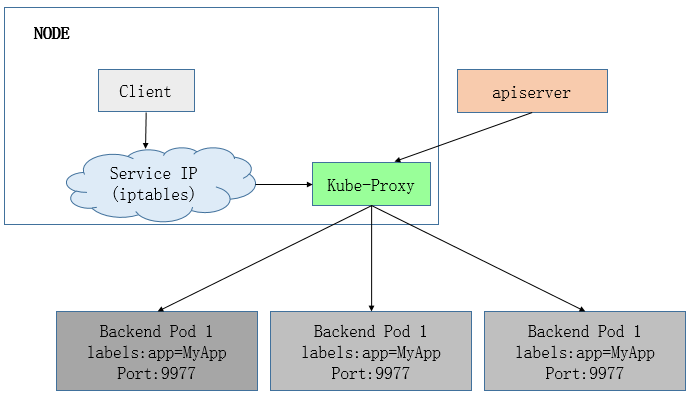 可见,userspace这种mode最大的问题是,service的请求会先从用户空间进入内核iptables,然后再回到用户空间,由kube-proxy完成后端Endpoints的选择和代理工作,这样流量从用户空间进出内核带来的性能损耗是不可接受的。这也是k8s v1.0及之前版本中对kube-proxy质疑最大的一点,因此社区就开始研究iptables mode.
userspace这种模式下,kube-proxy 持续监听 Service 以及 Endpoints 对象的变化;对每个 Service,它都为其在本地节点开放一个端口,作为其服务代理端口;发往该端口的请求会采用一定的策略转发给与该服务对应的后端 Pod 实体。kube-proxy 同时会在本地节点设置 iptables 规则,配置一个 Virtual IP,把发往 Virtual IP 的请求重定向到与该 Virtual IP 对应的服务代理端口上。其工作流程大体如下:
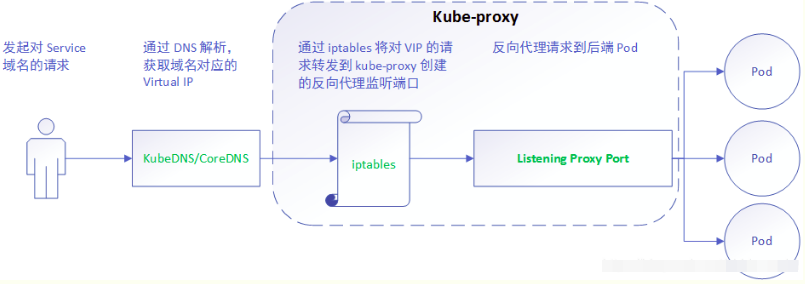 由此分析: 该模式请求在到达 iptables 进行处理时就会进入内核,而 kube-proxy 监听则是在用户态, 请求就形成了从用户态到内核态再返回到用户态的传递过程, 一定程度降低了服务性能。
2) iptables mode, 该模式完全利用内核iptables来实现service的代理和LB, 这是K8s在v1.2及之后版本默认模式. 工作原理如下:
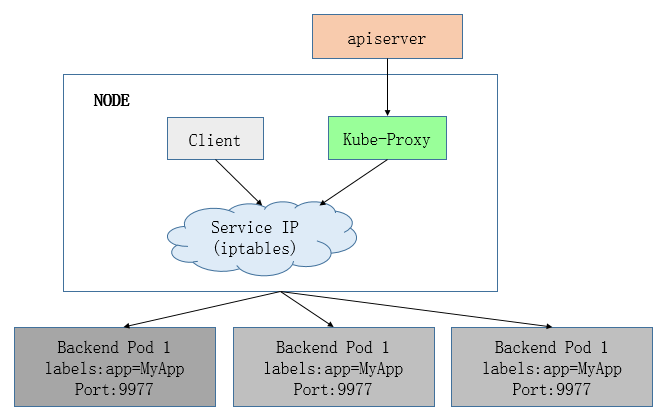 iptables mode因为使用iptable NAT来完成转发,也存在不可忽视的性能损耗。另外,如果集群中存在上万的Service/Endpoint,那么Node上的iptables rules将会非常庞大,性能还会再打折扣。这也导致目前大部分企业用k8s上生产时,都不会直接用kube-proxy作为服务代理,而是通过自己开发或者通过Ingress Controller来集成HAProxy, Nginx来代替kube-proxy。
iptables 模式与 userspace 相同,kube-proxy 持续监听 Service 以及 Endpoints 对象的变化;但它并不在本地节点开启反向代理服务,而是把反向代理全部交给 iptables 来实现;即 iptables 直接将对 VIP 的请求转发给后端 Pod,通过 iptables 设置转发策略。其工作流程大体如下:
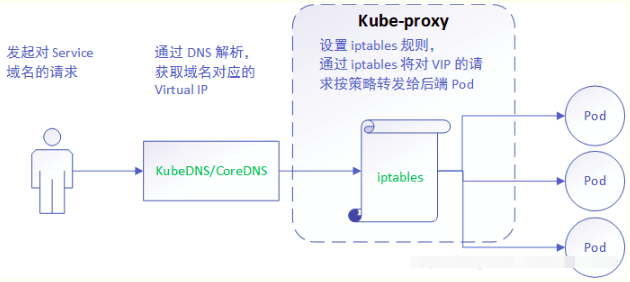 由此分析: 该模式相比 userspace 模式,克服了请求在用户态-内核态反复传递的问题,性能上有所提升,但使用 iptables NAT 来完成转发,存在不可忽视的性能损耗,而且在大规模场景下,iptables 规则的条目会十分巨大,性能上还要再打折扣。
iptables的方式则是利用了linux的iptables的nat转发进行实现:
apiVersion: v1
kind: Service
metadata:
  labels:
    name: mysql
    role: service
  name: mysql-service
spec:
  ports:
    - port: 3306
      targetPort: 3306
      nodePort: 30964
  type: NodePort
  selector:
    mysql-service: "true"
mysql-service对应的nodePort暴露出来的端口为30964,对应的cluster IP(10.254.162.44)的端口为3306,进一步对应于后端的pod的端口为3306。 mysql-service后端代理了两个pod,ip分别是192.168.125.129和192.168.125.131, 这里先来看一下iptables:
$iptables -S -t nat
...
-A PREROUTING -m comment --comment "kubernetes service portals" -j KUBE-SERVICES
-A OUTPUT -m comment --comment "kubernetes service portals" -j KUBE-SERVICES
-A POSTROUTING -m comment --comment "kubernetes postrouting rules" -j KUBE-POSTROUTING
-A KUBE-MARK-MASQ -j MARK --set-xmark 0x4000/0x4000
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/mysql-service:" -m tcp --dport 30964 -j KUBE-MARK-MASQ
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/mysql-service:" -m tcp --dport 30964 -j KUBE-SVC-67RL4FN6JRUPOJYM
-A KUBE-SEP-ID6YWIT3F6WNZ47P -s 192.168.125.129/32 -m comment --comment "default/mysql-service:" -j KUBE-MARK-MASQ
-A KUBE-SEP-ID6YWIT3F6WNZ47P -p tcp -m comment --comment "default/mysql-service:" -m tcp -j DNAT --to-destination 192.168.125.129:3306
-A KUBE-SEP-IN2YML2VIFH5RO2T -s 192.168.125.131/32 -m comment --comment "default/mysql-service:" -j KUBE-MARK-MASQ
-A KUBE-SEP-IN2YML2VIFH5RO2T -p tcp -m comment --comment "default/mysql-service:" -m tcp -j DNAT --to-destination 192.168.125.131:3306
-A KUBE-SERVICES -d 10.254.162.44/32 -p tcp -m comment --comment "default/mysql-service: cluster IP" -m tcp --dport 3306 -j KUBE-SVC-67RL4FN6JRUPOJYM
-A KUBE-SERVICES -m comment --comment "kubernetes service nodeports; NOTE: this must be the last rule in this chain" -m addrtype --dst-type LOCAL -j KUBE-NODEPORTS
-A KUBE-SVC-67RL4FN6JRUPOJYM -m comment --comment "default/mysql-service:" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-ID6YWIT3F6WNZ47P
-A KUBE-SVC-67RL4FN6JRUPOJYM -m comment --comment "default/mysql-service:" -j KUBE-SEP-IN2YML2VIFH5RO2T
首先如果是通过node的30964端口访问,则会进入到以下链:
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/mysql-service:" -m tcp --dport 30964 -j KUBE-MARK-MASQ
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/mysql-service:" -m tcp --dport 30964 -j KUBE-SVC-67RL4FN6JRUPOJYM
然后进一步跳转到KUBE-SVC-67RL4FN6JRUPOJYM的链:
-A KUBE-SVC-67RL4FN6JRUPOJYM -m comment --comment "default/mysql-service:" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-ID6YWIT3F6WNZ47P
-A KUBE-SVC-67RL4FN6JRUPOJYM -m comment --comment "default/mysql-service:" -j KUBE-SEP-IN2YML2VIFH5RO2T
这里利用了iptables的–probability的特性,使连接有50%的概率进入到KUBE-SEP-ID6YWIT3F6WNZ47P链,50%的概率进入到KUBE-SEP-IN2YML2VIFH5RO2T链。 KUBE-SEP-ID6YWIT3F6WNZ47P的链的具体作用就是将请求通过DNAT发送到192.168.125.129的3306端口:
-A KUBE-SEP-ID6YWIT3F6WNZ47P -s 192.168.125.129/32 -m comment --comment "default/mysql-service:" -j KUBE-MARK-MASQ
-A KUBE-SEP-ID6YWIT3F6WNZ47P -p tcp -m comment --comment "default/mysql-service:" -m tcp -j DNAT --to-destination 192.168.125.129:3306
同理KUBE-SEP-IN2YML2VIFH5RO2T的作用是通过DNAT发送到192.168.125.131的3306端口:
-A KUBE-SEP-IN2YML2VIFH5RO2T -s 192.168.125.131/32 -m comment --comment "default/mysql-service:" -j KUBE-MARK-MASQ
-A KUBE-SEP-IN2YML2VIFH5RO2T -p tcp -m comment --comment "default/mysql-service:" -m tcp -j DNAT --to-destination 192.168.125.131:3306
分析完nodePort的工作方式,接下里说一下clusterIP的访问方式。 对于直接访问cluster IP(10.254.162.44)的3306端口会直接跳转到KUBE-SVC-67RL4FN6JRUPOJYM
-A KUBE-SERVICES -d 10.254.162.44/32 -p tcp -m comment --comment "default/mysql-service: cluster IP" -m tcp --dport 3306 -j KUBE-SVC-67RL4FN6JRUPOJYM
接下来的跳转方式同NodePort方式。
3) ipvs mode. 在kubernetes 1.8以上的版本中,对于kube-proxy组件增加了除iptables模式和用户模式之外还支持ipvs模式。kube-proxy ipvs 是基于 NAT 实现的,通过ipvs的NAT模式,对访问k8s service的请求进行虚IP到POD IP的转发。当创建一个 service 后,kubernetes 会在每个节点上创建一个网卡,同时帮你将 Service IP(VIP) 绑定上,此时相当于每个 Node 都是一个 ds,而其他任何 Node 上的 Pod,甚至是宿主机服务(比如 kube-apiserver 的 6443)都可能成为 rs;
与iptables、userspace 模式一样,kube-proxy 依然监听Service以及Endpoints对象的变化, 不过它并不创建反向代理, 也不创建大量的 iptables 规则, 而是通过netlink 创建ipvs规则,并使用k8s Service与Endpoints信息,对所在节点的ipvs规则进行定期同步; netlink 与 iptables 底层都是基于 netfilter 钩子,但是 netlink 由于采用了 hash table 而且直接工作在内核态,在性能上比 iptables 更优。其工作流程大体如下:
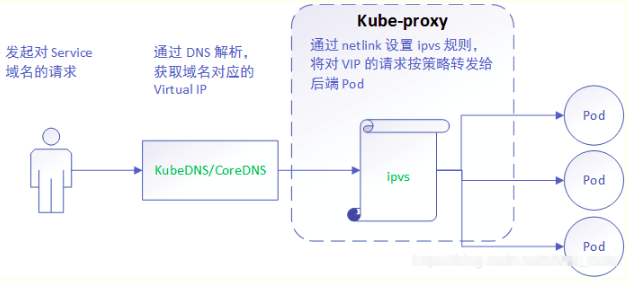 由此分析:ipvs 是目前 kube-proxy 所支持的最新代理模式,相比使用 iptables,使用 ipvs 具有更高的性能。 Endpoint访问外部服务
k8s访问集群外独立的服务最好的方式是采用Endpoint方式,以mysql服务为例:
1)创建mysql-service.yaml
[root@kevin~]# vim mysql-service.yaml
apiVersion: v1
kind: Service
metadata:
  name: mysql-kevin
spec:
  ports:
    - port: 3306

2) 创建mysql-endpoints.yaml
[root@kevin~]# vim mysql-endpoints.yaml
kind: Endpoints
apiVersion: v1
metadata:
  name: mysql-kevin
  namespace: default
subsets:
  - addresses:
      - ip: 172.16.60.55
    ports:
      - port: 3306

3) 测试连接数据库
[root@kevin~]# kubectl exec -it mysql-client-h7jk8 bash
bash-4.1# mysql -hmysql-kevin -u user -p
Enter password:
.........
mysql>

4) 查看这个service
[root@kevin~]# kubectl describe svc mysql-kevin
Name:           mysql-kevin
Namespace:      default
Labels:         <none>
Annotations:        <none>
Selector:       <none>
Type:           ClusterIP
IP:         10.254.125.157
Port:           <unset> 3306/TCP
Endpoints:      172.16.60.55:3306
Session Affinity:   None
Events:         <none>
下面简单说kube-proxy是如何实现一个请求经过层层转发最后落到某个pod上的整个过程,这个请求可能来自pod也可能来自外部。
-> kube-proxy为集群提供service功能,相同功能的pods对外抽象为service,service可以实现反向代理和服务发现。可以分为iptables模式和userspace模式。具体有iptables实现
-> 在反向代理方面,kube-proxy默认使用rr算法实现客户端流量分发到后端的pod
k8s的service和endpoine是如何关联和相互影响的?
-> api-server创建service对象,与service绑定的pod地址:称之为endpoints
-> 服务发现方面:kube-proxy监控service后端endpoint的动态变化,并且维护service和endpoint的映射关系
一个经典pod的完整生命周期
-> Pending
-> Running
-> Succeeded
-> Failed
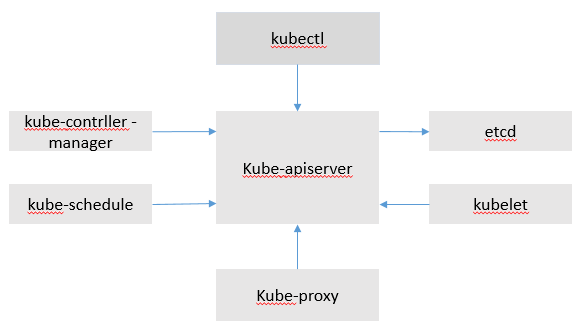
关系流程图如下:
 K8S Endpoint一会消失一会出现的问题
在使用K8s集群时遇到的问题:发现某个service的后端endpoint一会显示有后端,一会显示没有。显示没有后端,意味着后端的address被判定为notready。
经过排查确定原因:
kubelet在准备上报信息时,需要收集容器、镜像等的信息。虽然kubelet默认是10秒上报一次,但是实际的上报周期约为20~50秒。而kube-controller-manager判断node上报心跳超时的时间为40秒。所以会有一定概率超时。一旦超时,kube-controller会将该node上的所有pod的conditions中type是Ready的字典中的status置为False。
解决办法:
较为简单的方案是在kube-controller上配置这个超时时间node-monitor-grace-period长一些。建议配置为60 ~ 120s。
利用OpenKurise中的kruise做日志采集,原来我使用的是filebeat作为sidecar采集日志的,虽然采集没有什么问题,但是通过es进才看日志就比较繁琐了,这次实验p

RBAC(RoleBased Access Control)是 Kubernetes 中最核心、最常用的权限控制模型。无论你是平台管理员、SRE,还是 K8s 应用开发者,只要你需

在 Kubernetes 环境下,通过 Filebeat 采集容器日志并将其转发至日志平台(如 Kafka、Elasticsearch)是一种常见的日志解决方案。为了实现日志的可观
评论 0