
云原生
kubernetes集群中针对storageclass的扩容和高可用
先说一下我的需求,前几在部署生成环境的kubernetes集群时,针对存储这块用的都是nfs,但是前期规划的时候把nfs盘的数据和系统盘放一起了,当时太着急忘记这快了,现在因为数据
 推荐
玩了几年kubernetes,但是针对kubernetes的工具,推荐几个个人认为还算不错的工具。这里的工具主要是通过平台来管理kubernetes,方便给不太了解k8s的同学或者
 推荐
我们继续上一章的,点击开始后进入这个页面,会有一个欢迎视频,可以忽略点击底部的跳过,然后要求上传个人头像,这里也跳过,需要创建一个空间,这里我们创建运维部,开发部,产品部,测试部等
 推荐
安装gitlab时,使用rpm安装,提示错误: 这个错误提示,是因为gitlab安装时需要依赖policycoreutilspython。所以需要先安装policycoreutil
推荐kubernetes中rollout命令主要是针对资源进行管理,比如服务回滚,服务暂停,资源状态,查看历史等等。不过这里用的比较多的就是回滚版本,暂停资源,重新部署等下,下面看看在
 MySQL
ProxySQL / dble / MHA 的选型、配置与生产踩坑记录。
12 篇 · 更新于 2026-07 Kubernetes
日志采集、监控告警、RBAC、探针与调度的一线经验。
18 篇 · 更新于 2026-01 可观测性
Prometheus + Grafana + Loki 从部署到告警规则。
9 篇 · 更新于 2025-12MySQLProxySQL / dble / MHA 的选型、配置与生产踩坑记录。
12 篇 · 更新于 2026-07Kubernetes日志采集、监控告警、RBAC、探针与调度的一线经验。
18 篇 · 更新于 2026-01可观测性Prometheus + Grafana + Loki 从部署到告警规则。
9 篇 · 更新于 2025-12先说一下我的需求,前几在部署生成环境的kubernetes集群时,针对存储这块用的都是nfs,但是前期规划的时候把nfs盘的数据和系统盘放一起了,当时太着急忘记这快了,现在因为数据
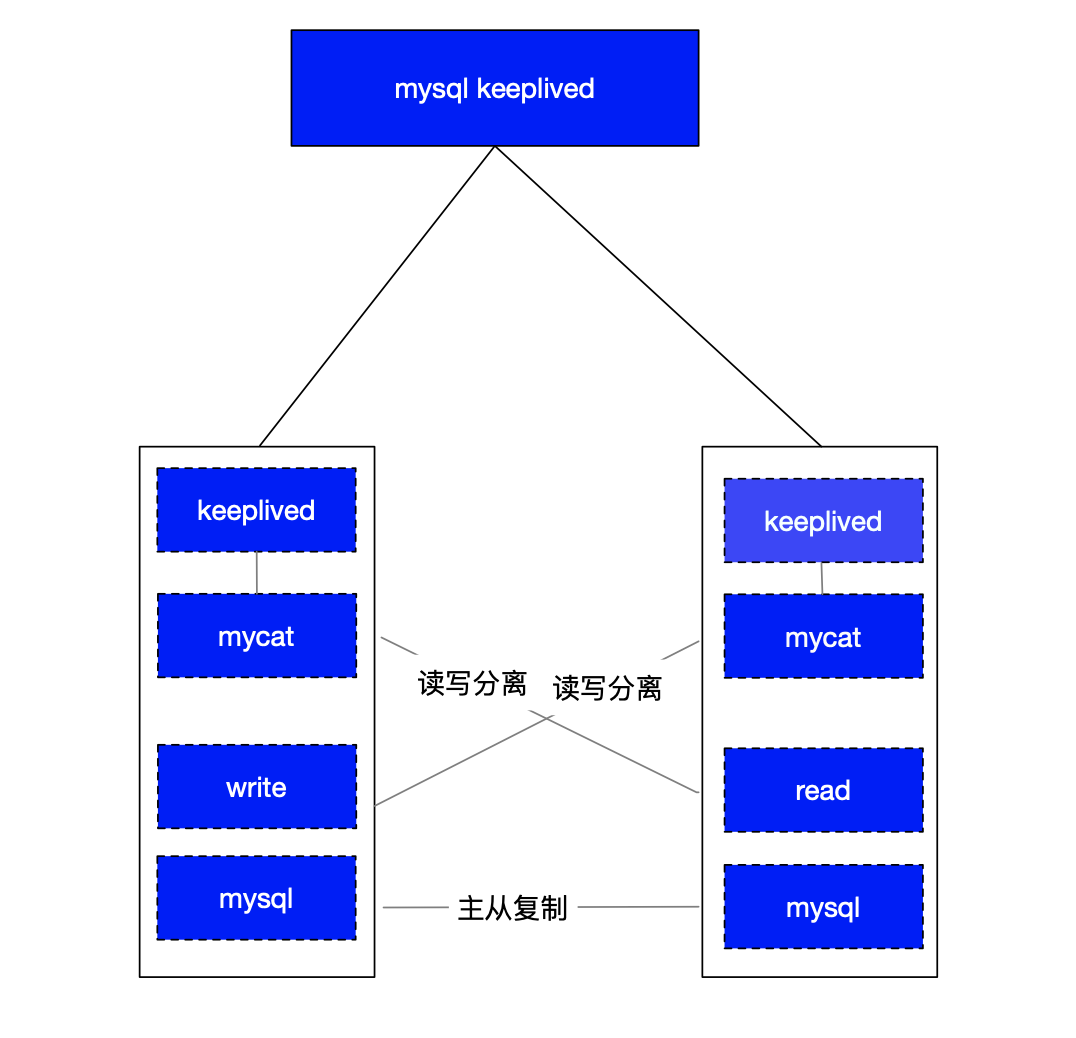
原因是为了解决单个节点的压力,并且在资源使用上做分离,目前的结构是通过keeplived做反向代理,转发到两个mycat中间件上,在两个mycat上做了读写分离配置,分别写入到主库

由于生产环境是不允许连接公网,但是又没有私有的yum源,那么在安装一些工具的时候就有点吃力了,如果使用二进制的方式安装,会有很多二进制依赖包,虽然可以离线安装,但是变的繁琐了,那么
已经部署好的es集群,但是接入到日志之后发现磁盘的io突然升高,但是数据量也不是很大,查看一下原因,原来是因为es集群在写入的时候导致的。下面看一下我排查的步骤 通过pidstat
在kubernetes中,使用到探针来检测服务的一个允许状态能够保障服务的稳定,也可以在出现异常的情况下可以让服务自动的重启,但是这种方式在运行的过程中,针对日志收集来说就会因为探
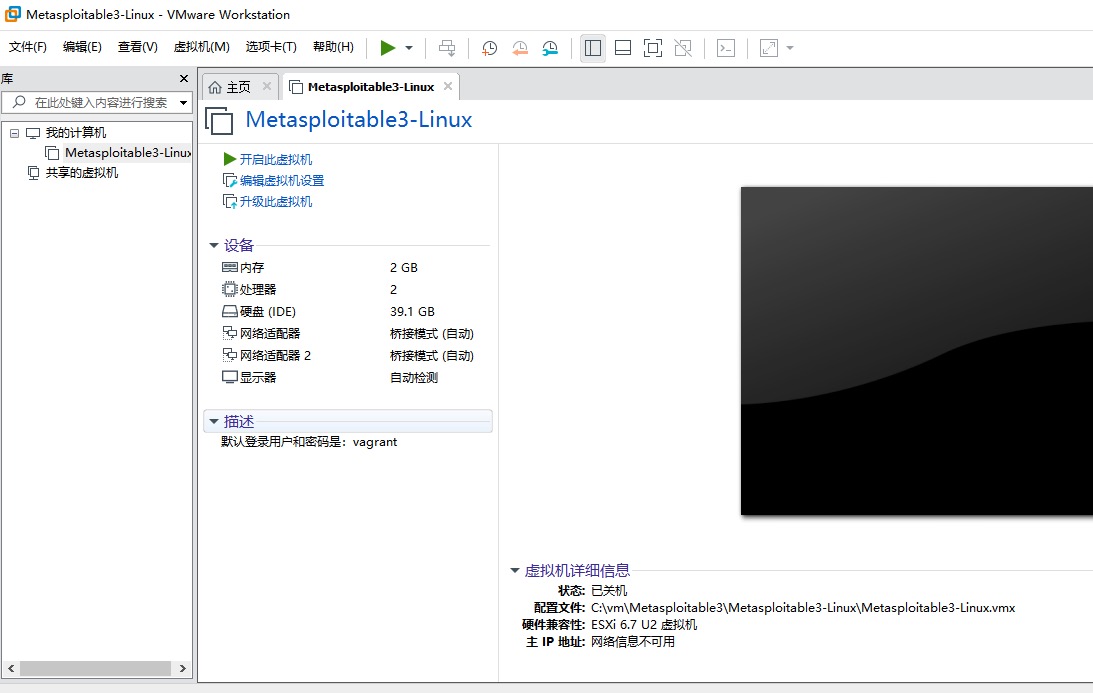
最近在学习渗透的知识,发现了一个问题,很多靶场都是用VMware做成的虚拟机靶场,针对我的parallels来说,确实有点难了,但是遇到难处总不能不学了,不可能的,又没有部署方式,
\dig\(Domain Information Groper)是一个强大的命令行工具,用于查询DNS(Domain Name System)记录。它有许多参数和选项,可以帮助你获